01. 通用大模型API最反常的地方:客户拥有退出权,供应商没有休息权
开局两张图:
去年9月:
今年7月:
然后:2026年7月,微软在财报电话会上同时讲了两件事。[1]
第一件事,是公司当季资本开支达到约2784亿元人民币,其中约三分之二投向主要由CPU和GPU组成的短寿命资产;AI基础设施与使用增长已经开始拖累毛利率,研发所需的算力、人才和数据还在推高运营费用。[1][12]
第二件事,是一年内使用多家模型供应商的客户数量增长了5倍。微软把模型外面的上下文、记忆和执行系统拆出来,目的之一,是让每个模型都可以被替代。[1]
两件事放在一起,几乎就是通用大模型API的商业模式说明书:
- 供应商负责买机器、训模型和承担折旧
- 客户则通过多模型架构,保留随时更换供应商的选择权。
这门生意并不缺需求。Menlo Ventures估计,模型API支出已经从约238亿元人民币增长到约570亿元人民币。[4][12]
麻烦在于,规模增长没有改变其中的权力分配:最重的成本留给供应商,最灵活的选择权留给客户。
如果一家模型公司没有应用入口、专有数据、企业工作流和长期合同,只向市场出售通用模型的token,它卖出的就不是一套能够安稳续费多年的软件,而是一项每天重新报价、每隔几个月重新排名的能力。
02. 三行代码,拿走了供应商的定价权
现存市场上几乎所有的LLM供应厂商,只要求改动API key、base URL和模型名三处配置,就可以被平滑替代。
“换一个key就能踹掉老供应商”,我的这个判断其实只说对了一半。
对只做通用文本生成、没有深度绑定原生工具的负载,基础请求改道确实很便宜;但到了生产系统,新模型仍要重新经过提示适配、工具行为、延迟、容量、安全和合规评测。接口切换可以只用三行,系统迁移通常不止三行。[2][3]
不过,商业上的主动权并不取决于客户是否天天搬家,而取决于他有没有随时搬家的能力。
Menlo Ventures对150名技术决策者的调查,把“客户没有天天搬家”和“市场份额大幅重排”放在了同一张桌子上。[4]
| 观察指标 | 调查结果 | 说明 |
|---|---|---|
| 在原供应商内部升级 | 66% [4] | 模型变了,供应商没变 |
| 没有切换 | 23% [4] | 生产系统仍存在迁移摩擦 |
| 跨供应商切换 | 11% [4] | 真正完成了供应商迁移 |
| OpenAI生产使用份额 | 2023年底50% → 2025年中25% [4] | 指标是使用份额,不是收入份额 |
| Anthropic生产使用份额 | 2025年中32% [4] | 新增任务和迁移流量改变市场分配 |
这组样本不能代表整个行业,Menlo还是Anthropic和OpenRouter的投资者。但它至少说明,生产客户不必天天更换供应商,流量仍然可以在一年多时间里发生大幅重分配。[4]
这两个结果并不矛盾。多数企业可以继续留在原供应商内部,少数大规模负载的迁移、新客户的重新选择,以及同一客户把增量任务分给其他模型,都足以改变市场份额。客户不需要每个月更换供应商,也能持续把订单分散出去。
企业真正不愿放弃的,通常是已经跑通的评测体系、权限、数据、流程和责任边界。单个模型只是其中最容易替换的一环;供应商能否留住客户,取决于它有没有把合同、工具和工作流建在模型外面。
纯通用API恰好停留在关系最薄的一层:它提供最昂贵的能力,却不天然拥有最牢固的客户关系。客户甚至不用真的离开,只要替代方案足够可信,供应商的提价空间就已经受到约束。
03. 模型公司的研发没有暂停键
低黏性本身未必致命。大宗商品同样缺少品牌忠诚,仍然可以依靠成本优势和规模赚钱。通用模型API更难受的地方,是它出售的“商品规格”还在高速变化。
Claude 4发布一个月后,在Menlo样本中已占Anthropic用户使用量的45%;Sonnet 3.5的份额则从83%跌到16%。由于新旧模型属于同一家供应商,这次流量迁移没有把客户送给竞争对手,却展示了单代模型的使用量可以多快转移。[4]
官方退役记录也给出了相似的节奏。Claude Sonnet 3.7从2025年2月的版本发布到2026年2月退役,约一年;2025年5月版本的Sonnet 4和Opus 4,也在2026年6月退役。[5] 模型的经济寿命甚至可能更短,因为它往往会在正式退役之前先失去性能溢价。
对LLM厂商来说,最理想的结果,是旧模型流失的调用量被自己的新模型接住。客户完成一次内部升级,底层型号变了,供应商关系和账单还在。
但一旦继任模型迟到或者不达预期,事情就会反过来。旧模型仍在快速过时,客户却找不到留在原供应商内部的升级路径;已经部署好的兼容接口和多模型架构,便会把本应流向自家新模型的调用量送给竞争对手。研发掉队失去的,不只是下一代产品的增量市场,还包括上一代产品留下的存量。
行业的高速增长暂时遮住了这种风险。Menlo估计,模型API支出从约238亿元人民币增至约570亿元人民币,意味着供应商即使份额下降,绝对收入仍有可能增长。[4][12]
但收入最终由市场规模、供应商份额和实际成交价格共同决定。市场扩张可以补偿份额下降,降价可以暂时守住流量;如果总需求增速开始放缓,而份额与单位价格同时下行,过去被增长掩盖的压力就会集中显现。[4][8]

模型公司必须认真面对的,正是这种收入悬崖:客户的调用量不一定按照传统软件的续约周期慢慢离开,而可能随着一次模型评测和路由调整迅速改道。公开数据尚不足以证明哪家厂商已经发生绝对API收入崩塌,但从单代模型的流量迁移、供应商份额变化和价格趋势看,这条传导链已经存在。[4][8]
因此,前沿研发对模型公司不只是增长投入,更像保住存量收入的续费成本。下一代模型可以迟到,但旧模型的竞争力不会等它。
04. 设备可以跨代,模型溢价不能
而要不断用新模型接住旧流量,代价并不只是多招一些工程师。这场竞赛同时吞入研发预算、芯片、电力、数据中心、训练数据和高价人才。
| 成本证据 | 时间与量级 | 反映的压力 |
|---|---|---|
| 前沿模型摊销训练成本 | 2016年以来年均增长2.4倍,90%置信区间为2.0至2.9倍 [6] | 追逐前沿面对持续抬升的研发成本曲线 |
| Microsoft资本开支 | 2026财年第四季度约2784亿元人民币,约三分之二投向以CPU、GPU为主的短寿命资产 [1][12] | 推理和训练能力需要持续购置高折旧设备 |
| Alphabet资本开支 | 2025年约6206亿元人民币,约60%用于服务器、40%用于数据中心和网络 [7][12] | 基础设施投入不止是购买芯片 |
| Alphabet资本开支指引 | 2026年预计约1.19万亿至1.26万亿元人民币 [7][12] | 折旧、能源与运营费用继续压向利润表 |
其中,训练成本是研究者对历史运行的估算,不是任何一家公司的会计账簿;算法效率也可能改变单次训练成本。公司财报则展示了基础设施投入的规模,两组证据不能混成同一种成本口径。[1][6][7]
两家公司的巨额投入并非只服务通用模型API。微软和Alphabet还拥有云计算、广告、办公软件和自有应用,可以让同一套基础设施支撑多类收入。对缺少这些业务缓冲的模型厂商而言,同样的机器需要由更单一的收入来源完成回收——SpaceX模型能力掉队后转型出租算力就是一个例证。
模型迭代快,也不意味着上一代模型过气后,数据中心和GPU就会立刻报废。物理资产可以跨多代模型复用,会计折旧仍然按照资产寿命进行。
缩短的是能力溢价的回收窗口。
一代模型领先时,厂商需要尽快把性能优势换成调用量、合同和现金流;竞争对手追上后,同一批机器仍可继续工作,但它们生产的token只能按照新的市场价格出售。设备的使用寿命以年计算,领先模型的定价窗口却可能以月计算。
于是,模型厂商必须同时做两件互相拉扯的事:继续扩大训练和基础设施投入,追赶下一代能力;同时降低上一代模型的推理价格,避免通用负载被竞争对手带走。资本开支不是一次性门票,而是维持竞争资格的连续投入。
许多传统重资产企业也要提高设备利用率,但产品规格和单位售价不会频繁随着技术发布重新洗牌。模型基础设施即使保持满负荷,单位能力价格仍可能快速下降。机器没有闲着,并不等于上一轮研发投入还能继续获得原来的回报。[8]
05. 跟随者不需要赢,只需要够便宜
排行榜容易制造一种错觉:只有第一名的模型才有商业价值。[11]
但客户购买的不是名次,而是任务完成率。只要摘要、分类、抽取、客服回复或代码修改能够被评估、被重试、被路由,跟随者就不需要在所有维度超过最强模型,只需要跨过客户的“够用线”。所谓“90%的能力”,只能针对具体任务和具体评测,不能当成一个跨模型的统一指标。[8][11]
价格下降已经给出了最直接的信号。Stanford AI Index估计,在固定GPT-3.5级MMLU门槛后,推理价格从2022年11月每百万token约135.80元人民币,降至2024年10月的约0.48元人民币,18个月下降超过280倍。[8][12]
能力差距也在部分评测中收窄。2026年Stanford AI Index观察到,头部公司模型在人类偏好排行中的表现正在收敛:顶尖开放与闭源模型差距为3.3%,美中顶尖模型差距为2.7%。报告同时提醒,一些常用评测存在严重的数据质量问题,这些数字不能代表所有真实任务,却足以说明“只有最前沿模型可用”的场景正在减少。[11]
2026年7月31日,DeepSeek将V4-Flash-0731 API投入公开测试。官方变更日志称,新版本没有改变预览版的架构和规模,主要依靠再后训练,就在多项Agent评测上超过了V4-Pro预览版;API调用方式和模型名也没有变化。[9]
两天后,一篇题为《DeepSeek V4 Flash 斩杀线》的文章,把Artificial Analysis的价格—性能散点图称为一条“斩杀线”。图里的变化可以压缩成下面这张表:[10]
| 指标 | 预览版 | 0731公测版 [9][10] |
|---|---|---|
| Artificial Analysis智能指数 | 约40 [10] | 50 [10] |
| 每个加权评测任务成本 | 与新版本几乎相同 [10] | 约0.20元人民币 [10][12] |
| 模型变化 | 原始基线 | 架构和规模不变,主要进行再后训练 [9] |
| 官方API价格 | 不作跨期比较 | 非缓存输入1元人民币、输出2元人民币/百万token [9] |
“斩杀线”的含义不是V4-Flash已经赢下所有任务,而是在几乎没有抬高评测任务成本的情况下,把综合指数从约40推到50。对其他模型厂商来说,原本可以收费的能力区间,又被一个低价版本向上吞掉了一截。[10]
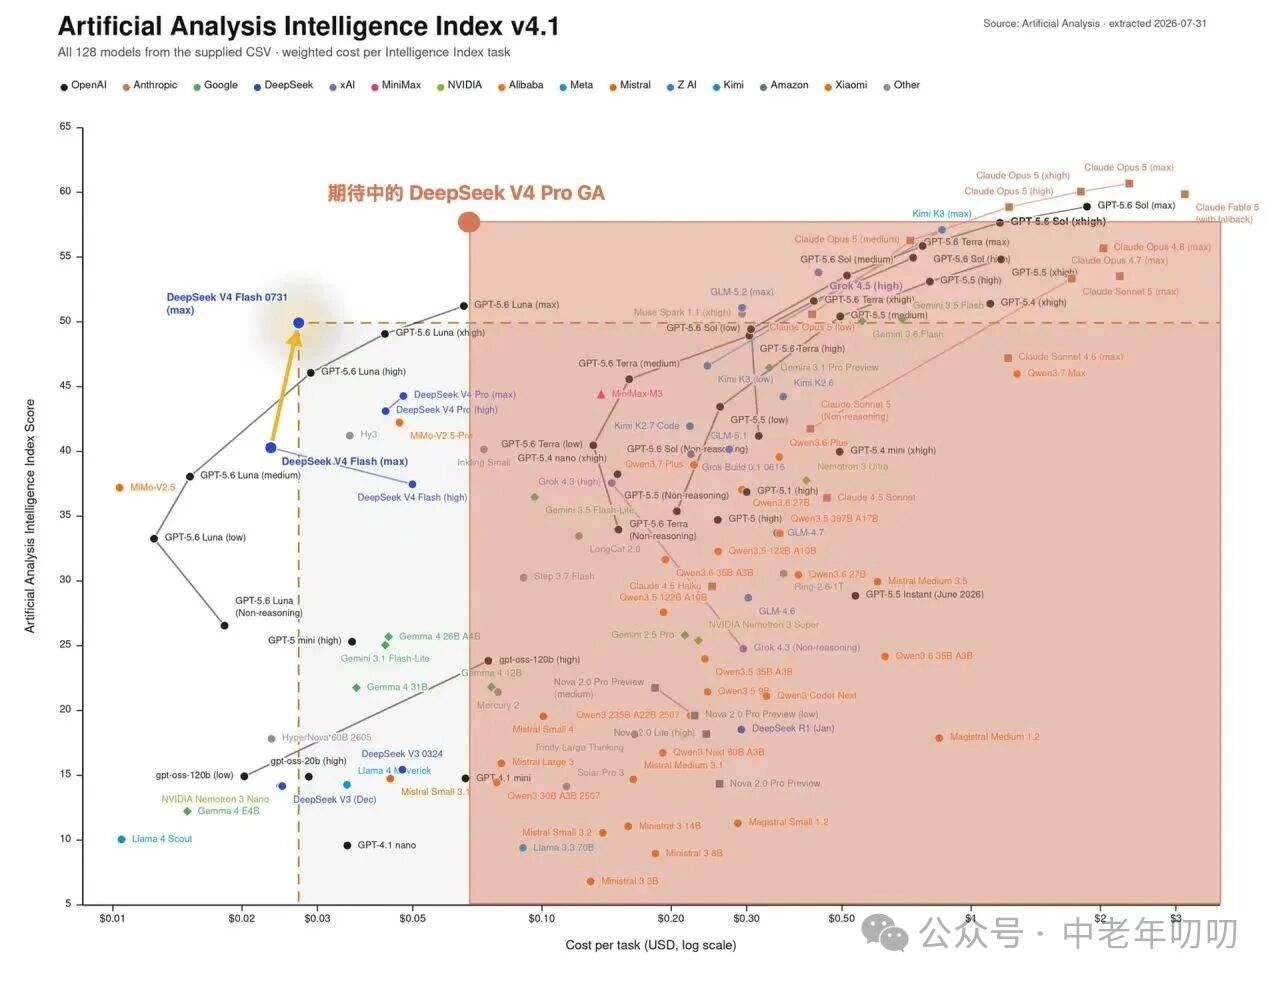
这张图也有明确边界。Artificial Analysis v4.1是由九项评测组成的英文纯文本综合指数,约0.20元人民币是每个加权评测任务的成本,不是一次真实编码任务或长上下文工作流的账单。V4-Flash-0731跑完整套指数生成约2.10亿输出token,高于同类模型约1亿的中位数;总评测成本约为489元人民币,说明低token单价仍可能被更长输出部分抵消。[10][12]
低价跟随者也不会赢得所有市场。Menlo样本中,DeepSeek的生产使用份额只有1%,开放模型工作负载占比还从19%降到13%;企业会为更高的性能、合规、稳定性和服务支持付费,而不只盯着token价格。[4]
可是,跟随者并不需要吃下所有客户。它只要截走大量标准化、价格敏感的负载,就能把前沿厂商推入一个两难选择:跟价,单位毛利和资本回收能力下降;不跟,最容易规模化的通用流量被路由出去,只剩真正需要前沿能力的高价值任务。
“90%能力、10%价格”这类策略的杀伤力也在这里。它未必取代第一名,却能把第一名已经规模化出售的能力,迅速变成一种更便宜的市场基线。[8][9][10]
所以,通用模型API之所以是一门很差的生意,不是因为它卖不出去,而是因为它同时具备四个条件:
- 客户掌握替代权
- 厂商没有研发休息权
- 资产投入巨大
- 产品溢价又会被低价跟随者快速压缩
需求越旺,这门生意越能做大;竞争越充分,它却越难积累传统软件式的存量利润。
模型厂商当然还有出路:向上占领应用、工作流、企业治理和专有数据,向下掌握芯片、能源与基础设施效率,再用容量合同和服务保障延长客户关系。只是走到那一步,它赚到的钱已经不再来自“一个通用模型加一张token价目表”,而是来自模型之外的系统。
客户改掉三行配置,只需要几分钟。供应商为了不被改掉,要建设下一座数据中心,启动下一轮训练,再参加下一次考试。[2][3]
这就是通用大模型API最反常的地方:客户拥有退出权,供应商没有休息权。
06. 关键来源
[1] Microsoft Investor Relations, Microsoft Fiscal Year 2026 Fourth Quarter Earnings Conference Call , 2026-07-29,访问于2026-08-03:https://www.microsoft.com/en-us/investor/events/fy-2026/earnings-fy-2026-q4
[2] Google AI for Developers, OpenAI compatibility , 2026-07-21,访问于2026-08-03:https://ai.google.dev/gemini-api/docs/openai
[3] Anthropic, OpenAI SDK compatibility , 2025-02-27,访问于2026-08-03:https://platform.claude.com/docs/en/cli-sdks-libraries/libraries/openai-sdk
[4] Menlo Ventures, 2025 Mid-Year LLM Market Update , 2025-07-31,访问于2026-08-03:https://menlovc.com/perspective/2025-mid-year-llm-market-update/
[5] Anthropic, Model deprecations , 页面更新于2026-06-05,访问于2026-08-03:https://platform.claude.com/docs/en/about-claude/model-deprecations
[6] Epoch AI、Stanford等研究者, The rising costs of training frontier AI models , 2024-05-31,访问于2026-08-03:https://arxiv.org/abs/2405.21015
[7] Alphabet Investor Relations, Alphabet 2025 Q4 Earnings Call , 2026-02-04,访问于2026-08-03:https://abc.xyz/investor/events/event-details/2026/2025-Q4-Earnings-Call-2026-Dr_C033hS6/default.aspx
[8] Stanford HAI, AI Index 2025: State of AI in 10 Charts , 2025-04-07,访问于2026-08-03:https://hai.stanford.edu/news/ai-index-2025-state-of-ai-in-10-charts
[9] DeepSeek API Docs, Change Log: DeepSeek-V4-Flash Update 与 模型 & 价格 , 2026-07-31,访问于2026-08-03:https://api-docs.deepseek.com/updates/ ;https://api-docs.deepseek.com/zh-cn/quick_start/pricing
[10] Reddit r/LocalLLM, DeepSeek V4 Flash just drew a pretty brutal “kill line” on this chart , 2026-08-02;Artificial Analysis, DeepSeek V4 Flash 0731 (max) - Intelligence, Performance & Price Analysis , 页面版本2026-08-02,访问于2026-08-03:https://www.reddit.com/r/LocalLLM/comments/1vdmmsp/deepseek_v4_flash_just_drew_a_pretty_brutal_kill/ ;https://artificialanalysis.ai/models/deepseek-v4-flash
[11] Stanford HAI, Technical Performance, 2026 AI Index Report , 2026-04-13,访问于2026-08-03:https://hai.stanford.edu/ai-index/2026-ai-index-report/technical-performance
[12] 中国外汇交易中心、中国新闻网, 2026年8月3日人民币汇率中间价 ,2026-08-03,访问于2026-08-03:https://www.chinamoney.com.cn/chinese/bkccpr/ ;https://www.chinanews.com.cn/cj/2026/08-03/10671019.shtml
07. 原文来源
原文发表于微信公众号“中老年叨叨”(2026年8月3日 18:15)。查看微信公众号原文。