01. 2.8万亿参数之后,Kimi K3的创新藏在哪里
7月21号,我随手写了一篇大模型军备竞赛:形式开源,实质闭源——Kimi K3开源2.8 万亿参数的营销魔术
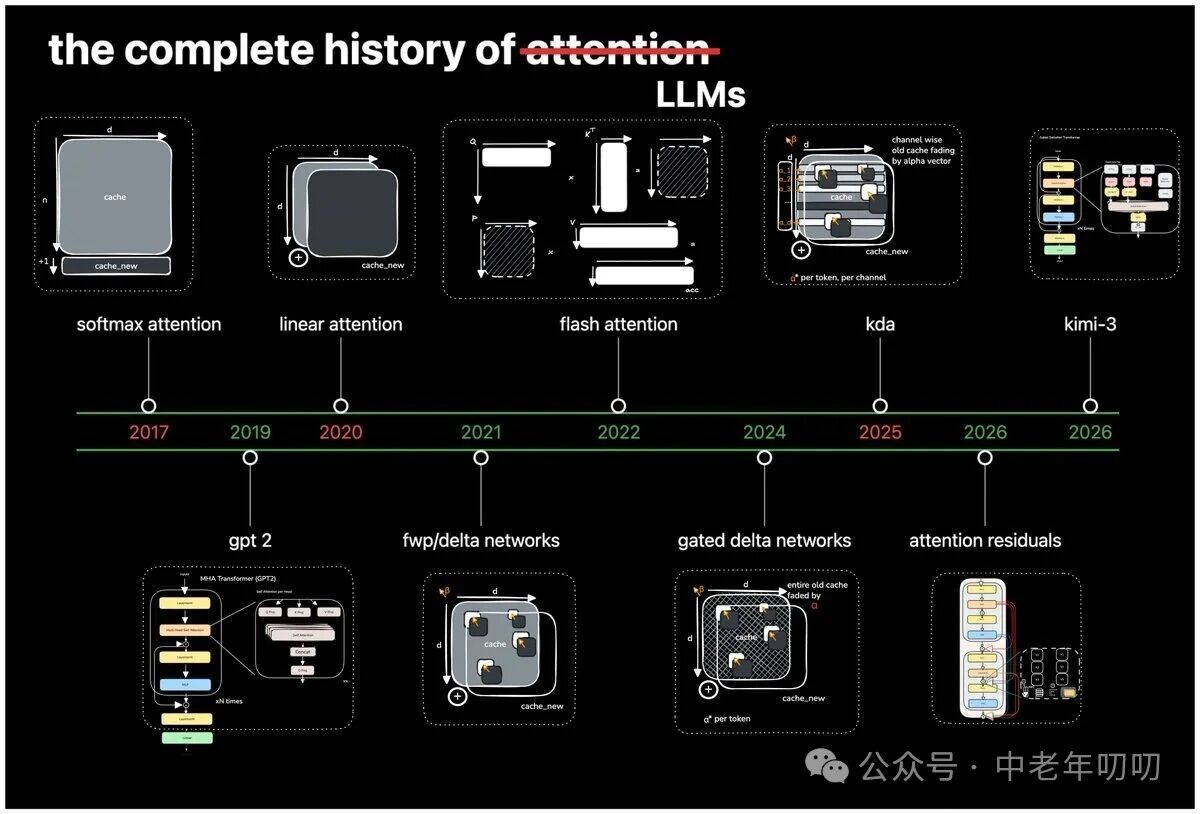
7月27日,一篇题为《22580: From GPT2 to Kimi3, Explained》:https://x.com/waterloo_intern/status/2081762065392541951 技术长文出现在X上。[1]
三天后,这篇文章已经有561万次浏览、接近3万次收藏。标题里的22580,是2.8万亿参数的Kimi K3与约1.24亿参数的GPT-2之间一个粗略的除法。[1]
这个数字很适合传播,也很容易把问题带偏。
2.8万亿是总参数,不是每次生成都会调用的参数。Kimi K3采用MoE架构,每次实际激活约1040亿参数。拿它和一款稠密模型直接比大小,有点像用商场的总建筑面积去比较上场内一家便利店的营业面积:都是真数字,但不是同一把尺子。[2]
那篇X长文更有价值的部分,不是算出了 22580 ,而是把七年架构变化压缩成了三个动作:
- 信息如何存储
- 记忆如何更新
- 需要时又如何检索。[1]
沿着这三个动作看,Kimi K3有没有创新的答案比“又一个 更大的 大模型”复杂。它有可辨认的架构创新,但这些创新来自一条连续演进的技术谱系;它发布了完整权重,但权重可下载、系统可部署和训练可复现,也不是一回事。[1][2]
这两天短视频平台一段内容在病毒式传播:Kimi的创始人语出惊人:OpenAI没有任何创新。同期老美那边不断在调查K3工程化蒸馏。由于短视频都是剪掉上下文语境来制造冲突和传播的,所以我也不评价这段没有创新,本文只拆解一下Kimi K3有没有创新,是不是真创新,不能只用一个“真”或“假”结账。[1][2]
02. 先把一条河装进水箱
大模型处理长上下文,首先遇到的是存储问题。
标准softmax注意力在自回归生成时,会把前面token的key和value保存在KV cache里。上下文越长,缓存越大。这种办法的好处是历史记录还在那里,模型需要时可以回头精确查找;代价是显存占用和数据搬运会随着序列长度增加。
递归线性注意力换了一种思路:不再把每个token的K和V都分别留下,而是把历史信息压进一个固定大小的状态矩阵。无论对话继续多少轮,水箱的外形不再跟着河流一起变长。[4][7]
但,省下来的内存不是总是好的。当越来越多信息被压进同一个固定状态,旧内容会互相干扰。模型得到了一只不会继续膨胀的水箱,也同时失去了可以逐页翻查的完整账本。
线性注意力真正难的部分,不是“怎么压缩”,而是容量有限之后,什么该留下,什么该覆盖。
Kimi团队在2025年的Kimi Linear里提出Kimi Delta Attention,也就是KDA。它没有把全注意力全部拿掉,而是采用混合结构:大约三层KDA之后,保留一层全局MLA。KDA负责低成本地维护固定状态,MLA负责在必要时回到完整上下文做精确检索。[4]
Kimi K3沿用了这套分工。官方规格中的93层注意力,由69层KDA和24层Gated MLA组成,比例仍然接近三比一。[2]
这组数字说明,Moonshot并没有相信一种新机制可以包打天下。KDA的价值是把大部分日常记忆压缩处理,MLA则像定期打开总账核对。快路径承担吞吐,慢路径保留精度,所谓混合架构,本质上是在给不同成本的检索方式分班。
这条路线也有比概念图更硬的证据。
Kimi Linear论文在48B总参数、3B激活参数的模型上做了匹配训练。团队报告称,相同训练配方下,混合KDA模型优于full MLA;在特定条件下,KV cache最多减少75%,一百万token上下文的解码吞吐最多提高约6倍。[4]
需要强调两处限定词: 团队报告+最多 。
技术论文里最容易被市场省略的,通常不是结果,而是结果前面的 实验条件 。[4]
03. 记忆的本质在于会忘
固定状态解决了“存多少”的问题,接下来是“怎么改”。
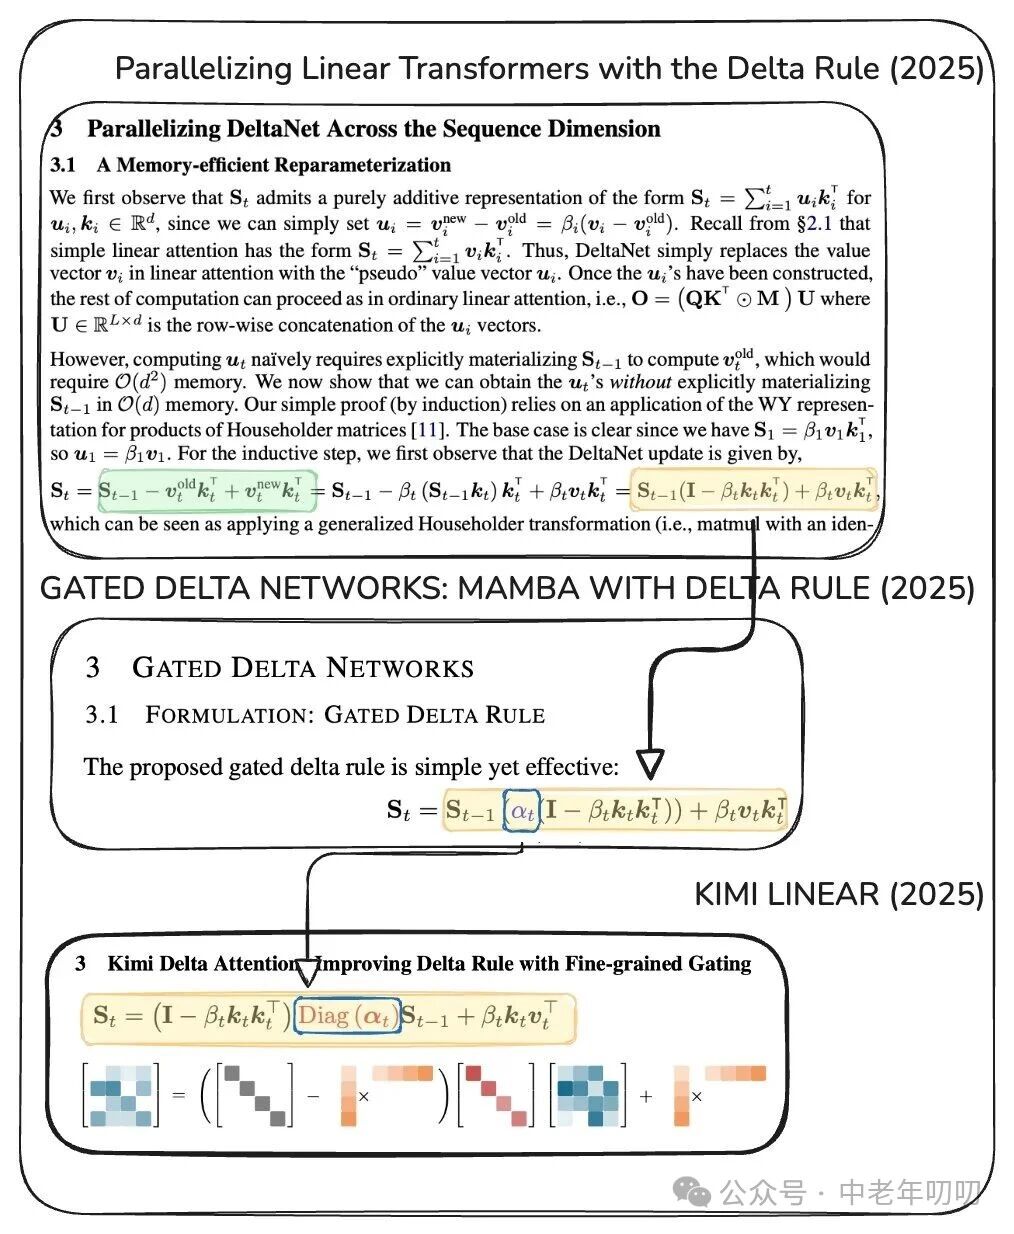
早期线性注意力主要做加法:新信息来了,就往状态里叠一层。只进不出,短时间很热闹,时间一长,记忆会像反复改写却从不删行的共享文档,最后每个人都能找到自己的痕迹,谁也说不清最新版是什么。
Delta rule的处理更精细。写入新值之前,模型先用当前key去读取状态里已有的内容,再只写入目标值和旧值之间的差异。它不再一味增加,而是先看原位置写了什么,再做定向修订。[5]
但定向修改仍然解决不了场景整体切换。
如果对话从代码突然转到法律合同,模型有时需要的不是修改某一条关联,而是让一批旧状态一起衰减。Gated DeltaNet把两种动作结合起来:delta rule负责局部改写,门控负责更快地遗忘旧状态。[5]
KDA在这条路上又走了一步。Gated DeltaNet的衰减控制相对粗,KDA把遗忘细化到不同通道,让状态矩阵的不同部分可以用不同速度更新,并为这种更新设计了更适合GPU分块执行的算法。[4][7]
这算创新 ,但不是从真空里掉下来的创新。
从线性注意力到DeltaNet,再到Gated DeltaNet和KDA,每一步都在修补上一代暴露出的记忆缺陷。KDA的贡献,是在既有谱系里把遗忘颗粒度和硬件执行向前推进,而不是在某个晚上重新发明了注意力。
反面证据也很重要。
2026年5月,NVIDIA研究者发表Gated DeltaNet-2,指出KDA仍把“擦除多少旧信息”和“写入多少新信息”绑在同一个标量上。新论文把两者拆开,并在13亿参数、1000亿token的实验里报告了对KDA等基线的总体优势。[7]
这不能证明Gated DeltaNet-2放大到2.8万亿参数后一定更好。它证明的是另一件事:KDA是一项可以准确描述、可以对照实验、也可以继续被后来者改进的技术。真正的架构创新往往长这样,不像纪念碑,更像代码仓里的一个版本号。[7]
Kimi K3还把同样的选择逻辑用在了参数容量上。[2]
它共有896个路由专家,每次选择16个,另外还有2个共享专家。于是模型可以拥有2.8万亿总参数,却不用每次都把2.8万亿参数全部算一遍。[2][3]
Moonshot把KDA、Stable LatentMoE、训练方法和数据配方合在一起,称其相对Kimi K2带来了约2.5倍的总体scaling efficiency。[3] 这个口径不能被拆成“某一个组件贡献了2.5倍”,但它揭示了K3真正的规模观:参数仍然要加,只是每一份参数都要有路由,每一次计算都要经过选择。
大力出奇迹,大力没有消失,只是开始学习怎么打方向盘。
04. 检索开始从横向转向纵向
存储和更新讨论的是token之间的记忆,Kimi K3还有另一条线:层与层之间的信息如何流动。[6]
传统PreNorm Transformer会把前面每一层的输出以固定权重不断加进残差流。网络越深,早期信息越容易被后来的表示稀释,后层如果想改变最终结果,也要对抗一条越来越厚的累积残差。
Attention Residuals,也就是AttnRes,把这种等权累加改成了检索。每一层不再只接受一锅已经混好的残差,而是用学习到的权重,从更早的层输出里选择当前最有用的表示。[6]
如果说MLA是在序列长度上回头找token,AttnRes就是在网络深度上回头找中间答案。一个横着查上下文,一个竖着查计算过程。
完整保存每一层输出又会带来新的内存和通信负担,于是Kimi团队设计了Block AttnRes:先把若干层压成块,再对块级表示做检索。精度让出一点,工程成本降下一截。这种折中很有K3的特点:它的架构不追求某个机制纯度最高,而是不断给昂贵路径安装一个可用的替代版本。[6]
AttnRes也不是只有一张示意图。公开论文做了scaling-law实验和消融,并把它放进48B总参数、3B激活参数的Kimi Linear模型,训练1.4万亿token,报告称各项下游任务都有改善。[6]
但证据边界仍然在这里。
AttnRes论文证明了机制在较小模型上的作用,Kimi K3技术报告证明了它进入2.8万亿参数系统;目前公开材料却没有把K3拆开,逐一回答拿掉KDA、AttnRes、Stable LatentMoE或SiTU之后,整机能力分别会下降多少。[6][8]
这也是判断“真创新”最容易犯的错误:看到一个新组件和一张更高的榜单,就默认前者解释了后者。
模型表现还同时受总规模、训练数据、后训练、推理预算、评测工具链、内核和基础设施影响。Moonshot自己的表述也把约2.5倍效率归因于结构、训练和数据配方的共同作用,并承认K3整体体验仍落后当时最强的闭源模型。[3]
所以,K3可以被判断为有架构创新,却不能因此直接推导出“领先来自架构”,更不能顺手再推导出“架构就是护城河”。从论文里的损失曲线到客户愿意付费,中间还隔着一整家公司。[3][4][6][8]
05. 三张不同的答卷
讨论到这里,可以给Kimi K3三张分开的答卷。
第一张是架构答卷。
KDA把固定状态里的遗忘细化到通道,混合MLA保留精确全局检索,AttnRes又把注意力从token维度带到了深度维度,Stable LatentMoE则让极高总参数与较低激活比例可以同时存在。这些组件都有明确问题、数学机制和实验依据。
因此,把K3说成“只有2.8万亿参数的数字游戏”并不准确。[2][4][6]
但把它说成从零开始的架构革命,也同样夸张。KDA站在DeltaNet和Gated DeltaNet之后,MoE、MLA和线性注意力也都有长期积累。K3更像一次高难度的系统集成:不是每个零件都由Moonshot首次发明,但团队确实重新设计了几个 关键零件 ,也把它们装进了此前没有出现过的规模。[4][5][7]
第二张是开放答卷。
Moonshot 官方 对K3的用词一直是open-weight。这个克制是对的。[2]
自媒体传播则众口一词:Open-source
截至7月30日,Hugging Face上的官方模型约1.56TB,分成96个safetensors权重文件;配置、tokenizer、processor和推理建模代码也可以读取。[9] 这不是“假开放”。研究者可以检查权重和实现,推理服务商可以适配,具备资源的团队可以部署和微调。
但当前 GitHub主仓只有README、许可证、技术报告和一张图片 ,Hugging Face仓库也 没有 提供完整的数据处理、预训练、SFT和RL训练流水线。按照OSI 1.0定义,完整的Open Source AI还应提供足够的数据说明以及完整训练、运行代码。[2][9][11]
许可证也不是一张没有条件的通行证。Kimi K3 License允许使用、复制、修改、分发和微调;但对 过去连续12个月总收入超过2000万美元的Model as a Service经营者,要求另行签约 ;超大商业产品还可能承担显著展示“Kimi K3”名称的义务。[10]
所以,更准确的结论不是“开源是假的”,而是K3已经完成了权重开放,没有完成OSI 1.0定义的 完整可复现开放 。前者的价值真实存在,后者的缺口也真实存在。[2][9][11]
第三张是工程与商业答卷。
这一张答卷,正好接上我上一篇《形式开源,实质闭源》。
那篇文章提出: 允许下载,不等于有能力使用 。看完K3的架构、仓库和部署材料后,这个问题应该保留,答案却需要修正。[2][3][9]
K3的开放权重是真的,使用能力分布不均也是真的。要看清两者如何同时成立,可以把所谓开放拆成四步:能下载,能运行,能修改,能复现。[2][9]
- 第一步已经完成:Hugging Face上的1.56TB模型分成96个权重文件,任何遵守许可证的人都可以取得。[9]
- 第二步只对少数团队开放:Moonshot建议用64个或更多加速器组成supernode部署完整模型;下载页面面向所有人,推荐配置显然不是为所有人准备的。[3][9]
到了K3,问题不再是把下载并这份工作简单放大,而是换了题型:分布式通信、专家路由、缓存、负载均衡、故障恢复和推理内核都成了生产系统的一部分。[2][3]
买得起设备、能让模型吐出第一段文字,和能把它稳定接进业务流程,仍然是三件事。上一篇关于工程门槛的判断,在这里依然成立。
- 第三步
下载K3开放权重文件后,并非只能原样调用。它可以量化、微调、替换推理实现、开发内核,也可以把模型部署在自己的基础设施上。Kimi Linear还公开了KDA内核和vLLM实现,这些都给出了更多的真实的技术控制权。[2][4][9]
- 边界出现在第四步。
当前公开材料没有包含完整的数据处理、预训练、SFT和RL训练流水线。外部团队可以改造已经训练好的模型,却还不能凭这些材料从头复现一个等价的Kimi K3。修改成品和重建生产过程,是两种不同层级的自由。[2][9][11]
因此,上一篇那句“你有权部署,但没有能力部署”,适合描述大多数企业,却不能代表所有使用者。研究机构、推理框架开发者、云厂商和极少数大型企业,确实能从权重与实现中获得API无法提供的价值;资源较少的团队,则大概率停在下载或实验阶段。
这不是开放消失了,也不是假的开放,而是开放的收益分布得很不平均。
商业问题也要沿着这条分层继续看。
对于没有现成GPU集群和ML基础设施团队的企业,购买API往往比自建完整推理系统更合理。云服务把硬件利用率、故障恢复、版本升级和人才成本打包出售,企业付钱买的并不只是token,也是在购买少踩几轮坑的时间。
这会让开放权重反过来帮助Moonshot的API 获客 。[2][3]
两条路径可以同时发生:极少数团队自己部署,多数企业购买服务;开放提高模型的可见度和可迁移性,云服务把复杂度重新收回来收费。
所以,这张答卷更准确的说法是:权重已经开放,能力仍然分层, “所谓的开源的” 商业价值会更多流向掌握基础设施和客户入口的人。开放改变了控制权的边界,却没有顺手消灭规模经济。
商业护城河因此不能只从架构图上读出来。KDA和AttnRes越公开,越可能被同行学习;真正难复制的部分,可能转移到训练数据、稳定训练超大模型的基础设施、推理内核、缓存系统、产品入口和客户工作流里。[2][3]
哪一种力量最后更强,需要部署量、推理成本、开发者采用和客户留存来回答。现在用一个benchmark分数提前宣布护城河,多少有点替财报抢戏。
06. 结语
ali那篇长文把Kimi K3从22580倍的数字里捞了出来。[1]
它不是为某家公司站台,而是提供了一个方法,把模型架构还原成三个具体问题:有限的状态里存什么,旧记忆到来时怎么改,需要信息时到哪里找。
按这三个问题,Kimi K3有真东西。它没有放弃规模,而是在规模继续增长时,为记忆、遗忘、检索和稀疏计算分别安排了机制。[4][6]
下载按钮把技术控制权交出了一部分,后面的机房、内核、许可证和组织能力,仍然要由使用者自己补齐。[3][9]
创新有,但是不多,且是真的。而创始人能不能说别人没有创新,不在本文讨论范畴[2][3]
07. 参考资料
[1] ali(@waterloo_intern):《22580: From GPT2 to Kimi3, Explained[1]》,2026-07-27。
[2] Moonshot AI:《Kimi-K3 README[2]》,2026-07-27。
[3] Moonshot AI:《Kimi K3 Tech Blog: Open Frontier Intelligence[3]》,2026-07-16。
[4] Kimi Team:《Kimi Linear: An Expressive, Efficient Attention Architecture[4]》,2025-10-30。
[5] Songlin Yang、Jan Kautz、Ali Hatamizadeh:《Gated Delta Networks: Improving Mamba2 with Delta Rule[5]》,2024-12-09。
[6] Kimi Team:《Attention Residuals[6]》,2026-03-16。
[7] Ali Hatamizadeh、Yejin Choi、Jan Kautz:《Gated DeltaNet-2: Decoupling Erase and Write in Linear Attention[7]》,2026-05-21。
[8] Moonshot AI:《Kimi K3: Open Frontier Intelligence[8]》,2026-07-28。
[9] Moonshot AI / Hugging Face:《moonshotai/Kimi-K3[9]》,访问于2026-07-30。
[10] Moonshot AI:《Kimi K3 License[10]》,2026-07-27。
[11] Open Source Initiative:《The Open Source AI Definition 1.0[11]》,2024-10-28。
08. 尚未验证
- 公开材料没有提供Kimi K3在2.8T总参数规模下逐一隔离KDA、AttnRes、Stable LatentMoE、SiTU和训练数据贡献的完整消融。[6][8]
- X长文作者关于SiTU未融合路径接近3倍变慢的观察尚无独立复现,本文未据此判断Kimi K3的普遍推理性能。[1]
- Kimi K3的架构创新能否形成可持续商业护城河,仍需部署成本、开发者采用、客户留存和独立评测数据验证。[2][3]
8.1 引用链接
[1] 22580: From GPT2 to Kimi3, Explained: https://x.com/waterloo_intern/status/2081762065392541951
[2] Kimi-K3 README: https://github.com/MoonshotAI/Kimi-K3/blob/main/README.md
[3] Kimi K3 Tech Blog: Open Frontier Intelligence: https://www.kimi.com/blog/kimi-k3
[4] Kimi Linear: An Expressive, Efficient Attention Architecture: https://arxiv.org/abs/2510.26692
[5] Gated Delta Networks: Improving Mamba2 with Delta Rule: https://arxiv.org/abs/2412.06464
[6] Attention Residuals: https://arxiv.org/abs/2603.15031
[7] Gated DeltaNet-2: Decoupling Erase and Write in Linear Attention: https://arxiv.org/abs/2605.22791
[8] Kimi K3: Open Frontier Intelligence: https://arxiv.org/abs/2607.24653
[9] moonshotai/Kimi-K3: https://huggingface.co/moonshotai/Kimi-K3
[10] Kimi K3 License: https://github.com/MoonshotAI/Kimi-K3/blob/main/LICENSE
[11] The Open Source AI Definition 1.0: https://opensource.org/ai/open-source-ai-definition
09. 原文来源
原文发表于微信公众号“中老年叨叨”(2026年7月30日 17:53)。查看微信公众号原文。