01. 当所有AI共享同一个关于你的记忆库
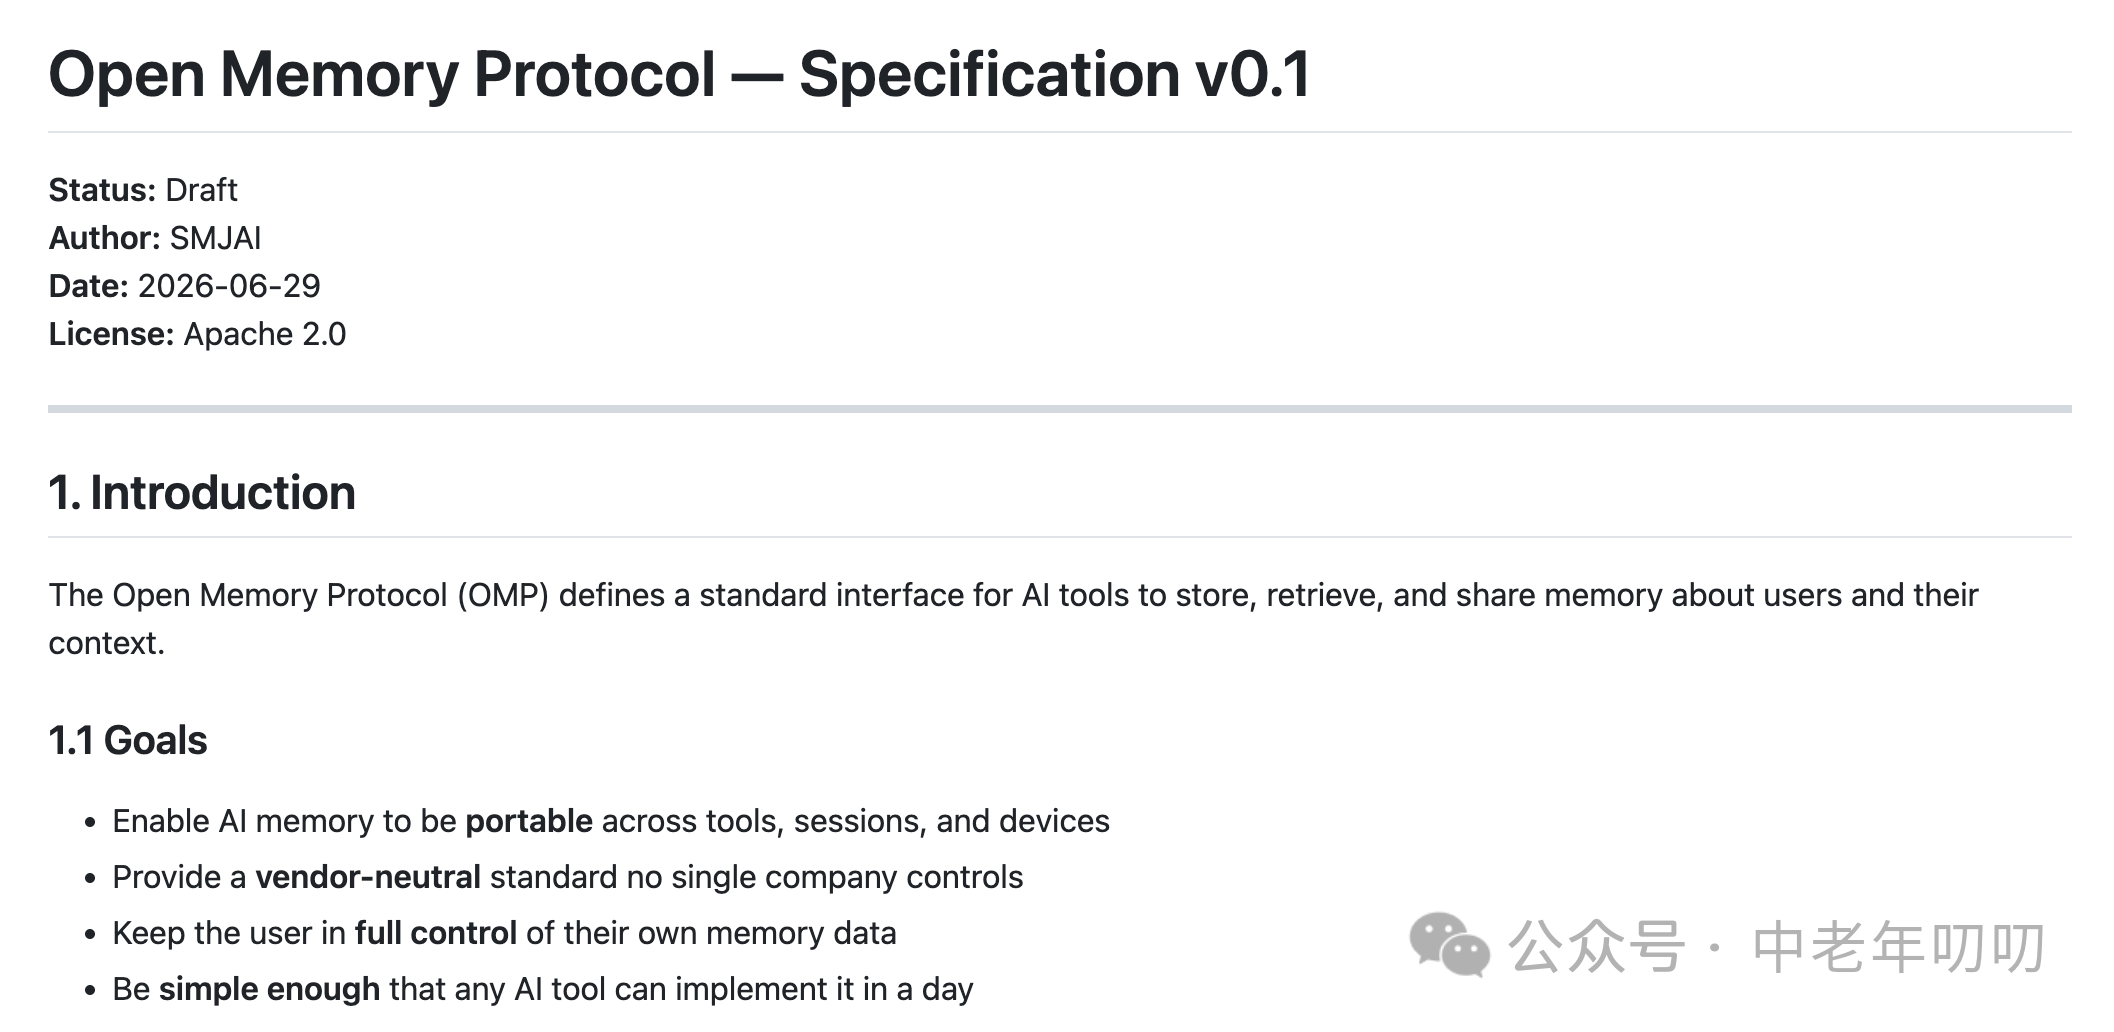
昨天 HN 热榜登顶的 Open Memory Protocol: https://github.com/SMJAI/open-memory-protocol 被技术圈欢呼为”AI 记忆孤岛的终结”。但如果换个视角——不是技术的视角,是知识本身的视角——这个开放协议的故事有另一面。 记忆碎片化不是缺陷,碎片化本身就是一种保护。 当所有 AI 工具共享同一个关于你的记忆库,你获得的便利,可能正在把分散的自我交给同一个系统。
如果所有 AI 工具共享同一个关于你的记忆库,会发生什么?
这不是思想实验。昨天 Hacker News 热榜上冒出一个叫 Open Memory Protocol(OMP)的东西——一个让 Claude、ChatGPT、Cursor 共用记忆的开放协议。技术圈在欢呼。
“AI 记忆孤岛终于要终结了。"
"开放协议才是未来。"
"自托管服务器,隐私可控,完美。”
一个开放协议,解决一个真问题,技术方向正确,开源、自托管、跨平台——所有正确的词都占了。
但我读完第一反应不是”太好了”,而是一个让人不舒服的问题:这到底是在解放记忆,还是在把分散的自我交给同一个系统?
02. 技术圈的叙事
先看看 OMP 解决了什么。
现在用各种AI工具(门派)普遍有一个痛点:不同工具之间的记忆是割裂的。
Claude 知道一个人的编程偏好,换到 Cursor 又要重新说一遍。ChatGPT 记住了项目背景,切到 Windsurf 就失忆了。每个 AI 工具都在自己的信息茧房里运作,换了工具等于换了一个人。
这确实是个问题。OMP 的方案也设计得不错——一个标准化的记忆存储协议,定义了三种记忆类型(事件、事实偏好、操作知识),提供简单的 API,支持自托管。跑一个服务器,所有 AI 工具往上面读写,记忆就打通了。
从工程角度看,这是一个干净的方案。从用户角度看,这是一个便利的承诺。
GitHub 上线一天就收获了大量关注。好几个同类项目也在同期涌现——OAMP、Akashik Protocol、Cecil、Mneme。这个赛道在 2026 年 6 月这个时间点,突然热了。
技术圈的核心叙事是: AI 记忆孤岛问题需要解决,开放协议是答案。
这个叙事听起来无懈可击。但问题在于——它只描述了第一层事实。
03. 一个更根本的问题
换个角度想:一个人的记忆为什么是割裂的?
表面答案是技术标准不统一——Claude 用一套记忆系统,ChatGPT 用另一套,Cursor 又用一套。OMP 要解决的就是这个。
但还有一个更深层的答案,可能不那么舒服: 一个人的知识本来就是碎片化、情境化、分布式的。
在 Claude 里讨论的是代码架构和编程偏好,在 ChatGPT 里写的是营销文案和选题思路,在 Cursor 里处理的是具体项目的屎山细节——这些本来就是不同上下文中的不同知识。它们之所以被割裂在不同的工具里,不是技术标准的缺陷,而是因为 这些知识本来就属于不同的”场景” 。
在代码上下文里说”我喜欢 TypeScript”,这是一个有边界的判断。它不需要也不应该被带入写营销文案的上下文。
强行把它们集中到一个”统一的记忆库”里,获得的是便利——不用重复说同样的话。
但失去的是什么? 一个人不同维度的信息,交给了同一个基础设施。
这件事的本质不是技术选择,而是权力结构的选择。
一个简单的思想实验:如果未来所有 AI 工具都默认接入同一个记忆协议,那掌握那个”默认记忆存储”的人——不管它是开源社区维护的、还是某家公司运营的——将拥有一个人所有维度的行为数据。工作中的技术决策、写作中的思考过程、投资中的判断逻辑、深夜问 AI 的那些”愚蠢问题”——全部在同一个地方。
表面看只是想”少说几遍编程偏好”。
但实际在做的是: 把分散的自我,集中到一个系统里。
知识一旦被集中,权力也就被集中了。这不是阴谋论,这是一个被反复验证过的社会规律。
有意思的是,OMP 自己也意识到了这个问题。它的分类存储设计——事件、事实偏好、操作知识——理论上可以让人只共享特定类型的记忆。但这个功能的价值取决于怎么用:是用它来 隔离 不同场景的记忆,还是用它来 合并 所有场景的记忆。前一个是保护,后一个是加速集中。工具给了选择,但大多数人不会主动选”更麻烦的那个”。
04. 自托管的承诺 vs 生态系统的引力
OMP 的团队显然考虑到了隐私问题。他们设计了自托管方案——每个人可以自己跑服务器,数据不出自己的控制。
这个设计是真诚的。但问题不在设计,在演化方向。
几个历史案例摆在那里:
电子邮件是开放的(SMTP 协议),但大多数人用 Gmail。
网站是开放的(HTTP 协议),但大多数人活在几个超级平台里。
即时通讯是开放的(XMPP 协议),但最终还是被商业产品吞噬。
开放协议在理论上给了自由,但在实践中,大多数用户会选择”最方便的那个实现”而不是”最开放的那个实现”。
当 OMP 成为事实标准后,会发生什么?
第一步:AI 工具原生内置 OMP 支持,开箱即用。
第二步:用户不需要自己搭服务器,直接用工具厂商提供的”默认记忆存储”。
第三步:“默认记忆存储”逐步变成”唯一记忆存储”——因为自托管版本的功能开始落后。
第四步:一个人的记忆不在自己的服务器上,而在某个 AI 公司的数据库里。
这不是受害者推论和阴谋论。这是网络效应的自然结果。 当所有人都用同一个记忆协议,那管理这个协议的服务器——不管是谁运营管理的——都拥有了所有维度的用户数据。
OMP 的自托管方案在理论上可以阻止这个演化方向。跑一个 docker run -p 3456:3456 -v omp-data:/data ghcr.io/smjai/omp-server 并不难。但关键不是能不能跑起来,而是当自托管版本的功能开始落后于云版本、当所有主流 AI 工具默认接入的是厂商的”官方记忆存储”而不是个人服务器的时候——有多少人会坚持维护自己的那台服务器?历史经验不太乐观——只有极少数极客。
这让我想起前段时间研究 AI 量化时的感受。一开始想的是”用 AI 挖掘更多信号就能赚钱”。结果发现:当几万个量化策略都在用 AI 挖掘同一个信号时,信号迅速衰减。真正赚钱的不是信号最丰富的人,而是数据最独家的人——那些能从交易所直接拿 tick 级数据、用卫星拍停车场算零售流量的机构。
开放协议让信息更丰富,但也让信息更拥挤。 当所有人的记忆都在同一个池子里,真正有价值的就不再是池子里的信息,而是池子之外的信息。
05. 不是 OMP 的问题,是”开放”叙事的问题
有一点应该说清楚:OMP 本身不是坏东西。
它的技术设计合理,团队的方向是真诚的,自托管方案是认真的。如果使用场景不涉及敏感信息,跑一个 OMP 服务器确实能提升体验。
真正的风险不是 OMP 本身,而是”开放协议”这个叙事带来的麻痹感。
当所有人都认为”开放 = 好 = 安全”的时候,就没人去问”集中 = 什么”了。
我自己有一个直观的体验。当我把思维方式拆解成 AI 能理解的结构(也就是我在做的 SOUL.md),AI 的分析结论准确得令人不安。它看透了我自己都没意识到的一些模式。但如果这些数据不是只属于我的,而是被标准化、可迁移、跨平台共享的——那”了解我”这件事就不再是我和 AI 之间的私事。
更深一层的问题是: 不是有人恶意利用数据,而是人们主动把数据交给了同一个系统,并相信这个系统永远是中立的。
这个陷阱很隐蔽。甚至不会觉得自己在做选择——只是在用最方便的方式同步记忆而已。但历史上所有”最方便”的路径,最终都通向权力的集中。SMTP 协议是开放的,但大多数人用 Gmail。HTTP 协议是开放的,但大多数人活在几个超级平台里。开放协议从来不缺,缺的是对”开放”保持警觉的人。
技术从来不是中性的。开放协议也不例外。
但记忆层只是第一层。往下挖,模型层、工具层、应用层——每一层都在上演同一个剧本。OMP 的故事不是孤例,它是一个更大模式的入口。
06. 一件事被欢呼”开放”的时候
可能我过度解读了一个简单的技术协议。也许吧。
但过去多年的经验告诉我: 当所有人都欢呼一个东西”开放”的时候,最值得问的问题是——它开放给了谁?
开放协议从来不是一个技术终点。它只是一个起点。协议本身不产生价值,产生价值的是围绕协议建立的生态。我个人的工作在相当长的时间内就是生态合作,我的经验认知中,生态最终会有它自己的演化逻辑——一开始是开放的、竞争的、分散的,慢慢地变成集中的、统一的、难以退出的。
这不是谁的阴谋。这就是系统演化的自然方向。 因为集中的系统总是更”高效”——直到它不再高效为止。
当把所有记忆交给一个协议(哪怕是开放协议),在做的就是在认知层面建立一个”统一的调度系统”。表面上它更高效,实际上它消灭了信息的多样性、上下文的特异性、以及——很少有人提的—— 被忘记的价值 。
记忆不是越多越好。有些东西就该被忘记。在不同上下文中的不同”版本”,不需要被同步成一个连续的、完整的档案。碎片化不是缺陷,碎片化本身就是一种保护。
我最近开始做一件事:定期清除 AI 记忆库,让 AI 重新认识自己。我管这个叫”认知节食”。不是为了隐私——虽然也顺便保护了隐私——而是为了提醒自己一件事:人与 AI 的关系,应该由人来定义节奏,而不是让 AI 永远记住一切。偶尔的”失忆”也是一种主权宣示。
OMP 把记忆分成了三种类型:事件、事实偏好、操作知识。这个分类本身是有洞察力的。但一个有意思的巧合是——这三类恰好对应了某位老派经济学家说过的那三种无法被集中的知识:关于特定时空的知识、科学知识、实践技能。他说这三者一旦被集中,就会失真。OMP 试图把它们集中起来。这不是技术的胜利,这是那个老问题在新舞台上的重演。
技术应该扩展人的自由,而不是驯化人的行为。
开放记忆协议也不例外。
本文不是反对 OMP 或同类协议,而是希望在拥抱便利的同时,保持对权力结构的清醒。技术判断从来不只是技术问题。
#OpenMemoryProtocol #OMP #AI记忆 #开放协议 #AI隐私 #数据主权 #哈耶克 #知识分散性 #记忆孤岛 #AI伦理 #技术批判 #AI安全 #自托管 #SOUL.md #分散知识 #技术中立 #认知节食 #AI工具 #Claude #ChatGPT #Cursor #记忆标准化 #AI记忆协议 #数据集中化 #网络效应 #生态锁定 #AI量化 #AI记忆库 #中老年叨叨
07. 原文来源
原文发表于微信公众号“中老年叨叨”(2026年7月2日 07:30)。查看微信公众号原文。