01. 🚀 DeepSeek V4最新论文,DualPath突破带宽瓶颈 🔥
DeepSeek 刚刚联合北京大学与清华大学发布了名为 DualPath 的全新推理框架,旨在解决大模型智能体在长文本推理中的 I/O 瓶颈。
论文的原文链接在此:https://arxiv.org/pdf/2602.21548
本学渣连夜跟Gemini一起学习,总结了DualPath的核心思想:
打破“KV-Cache必须由预填充引擎来加载”的传统思维,通过动态分配这两条数据加载路径,充分释放并利用集群中解码引擎原本闲置的存储网络带宽(SNIC),从而解决Agent长文本推理场景下的I/O瓶颈问题
赶紧分享出来,下面文章AI写了80%的内容,我只负责大纲和逻辑体系,最后审核了一下。
首先是NotebookLM总结的一张图说明:
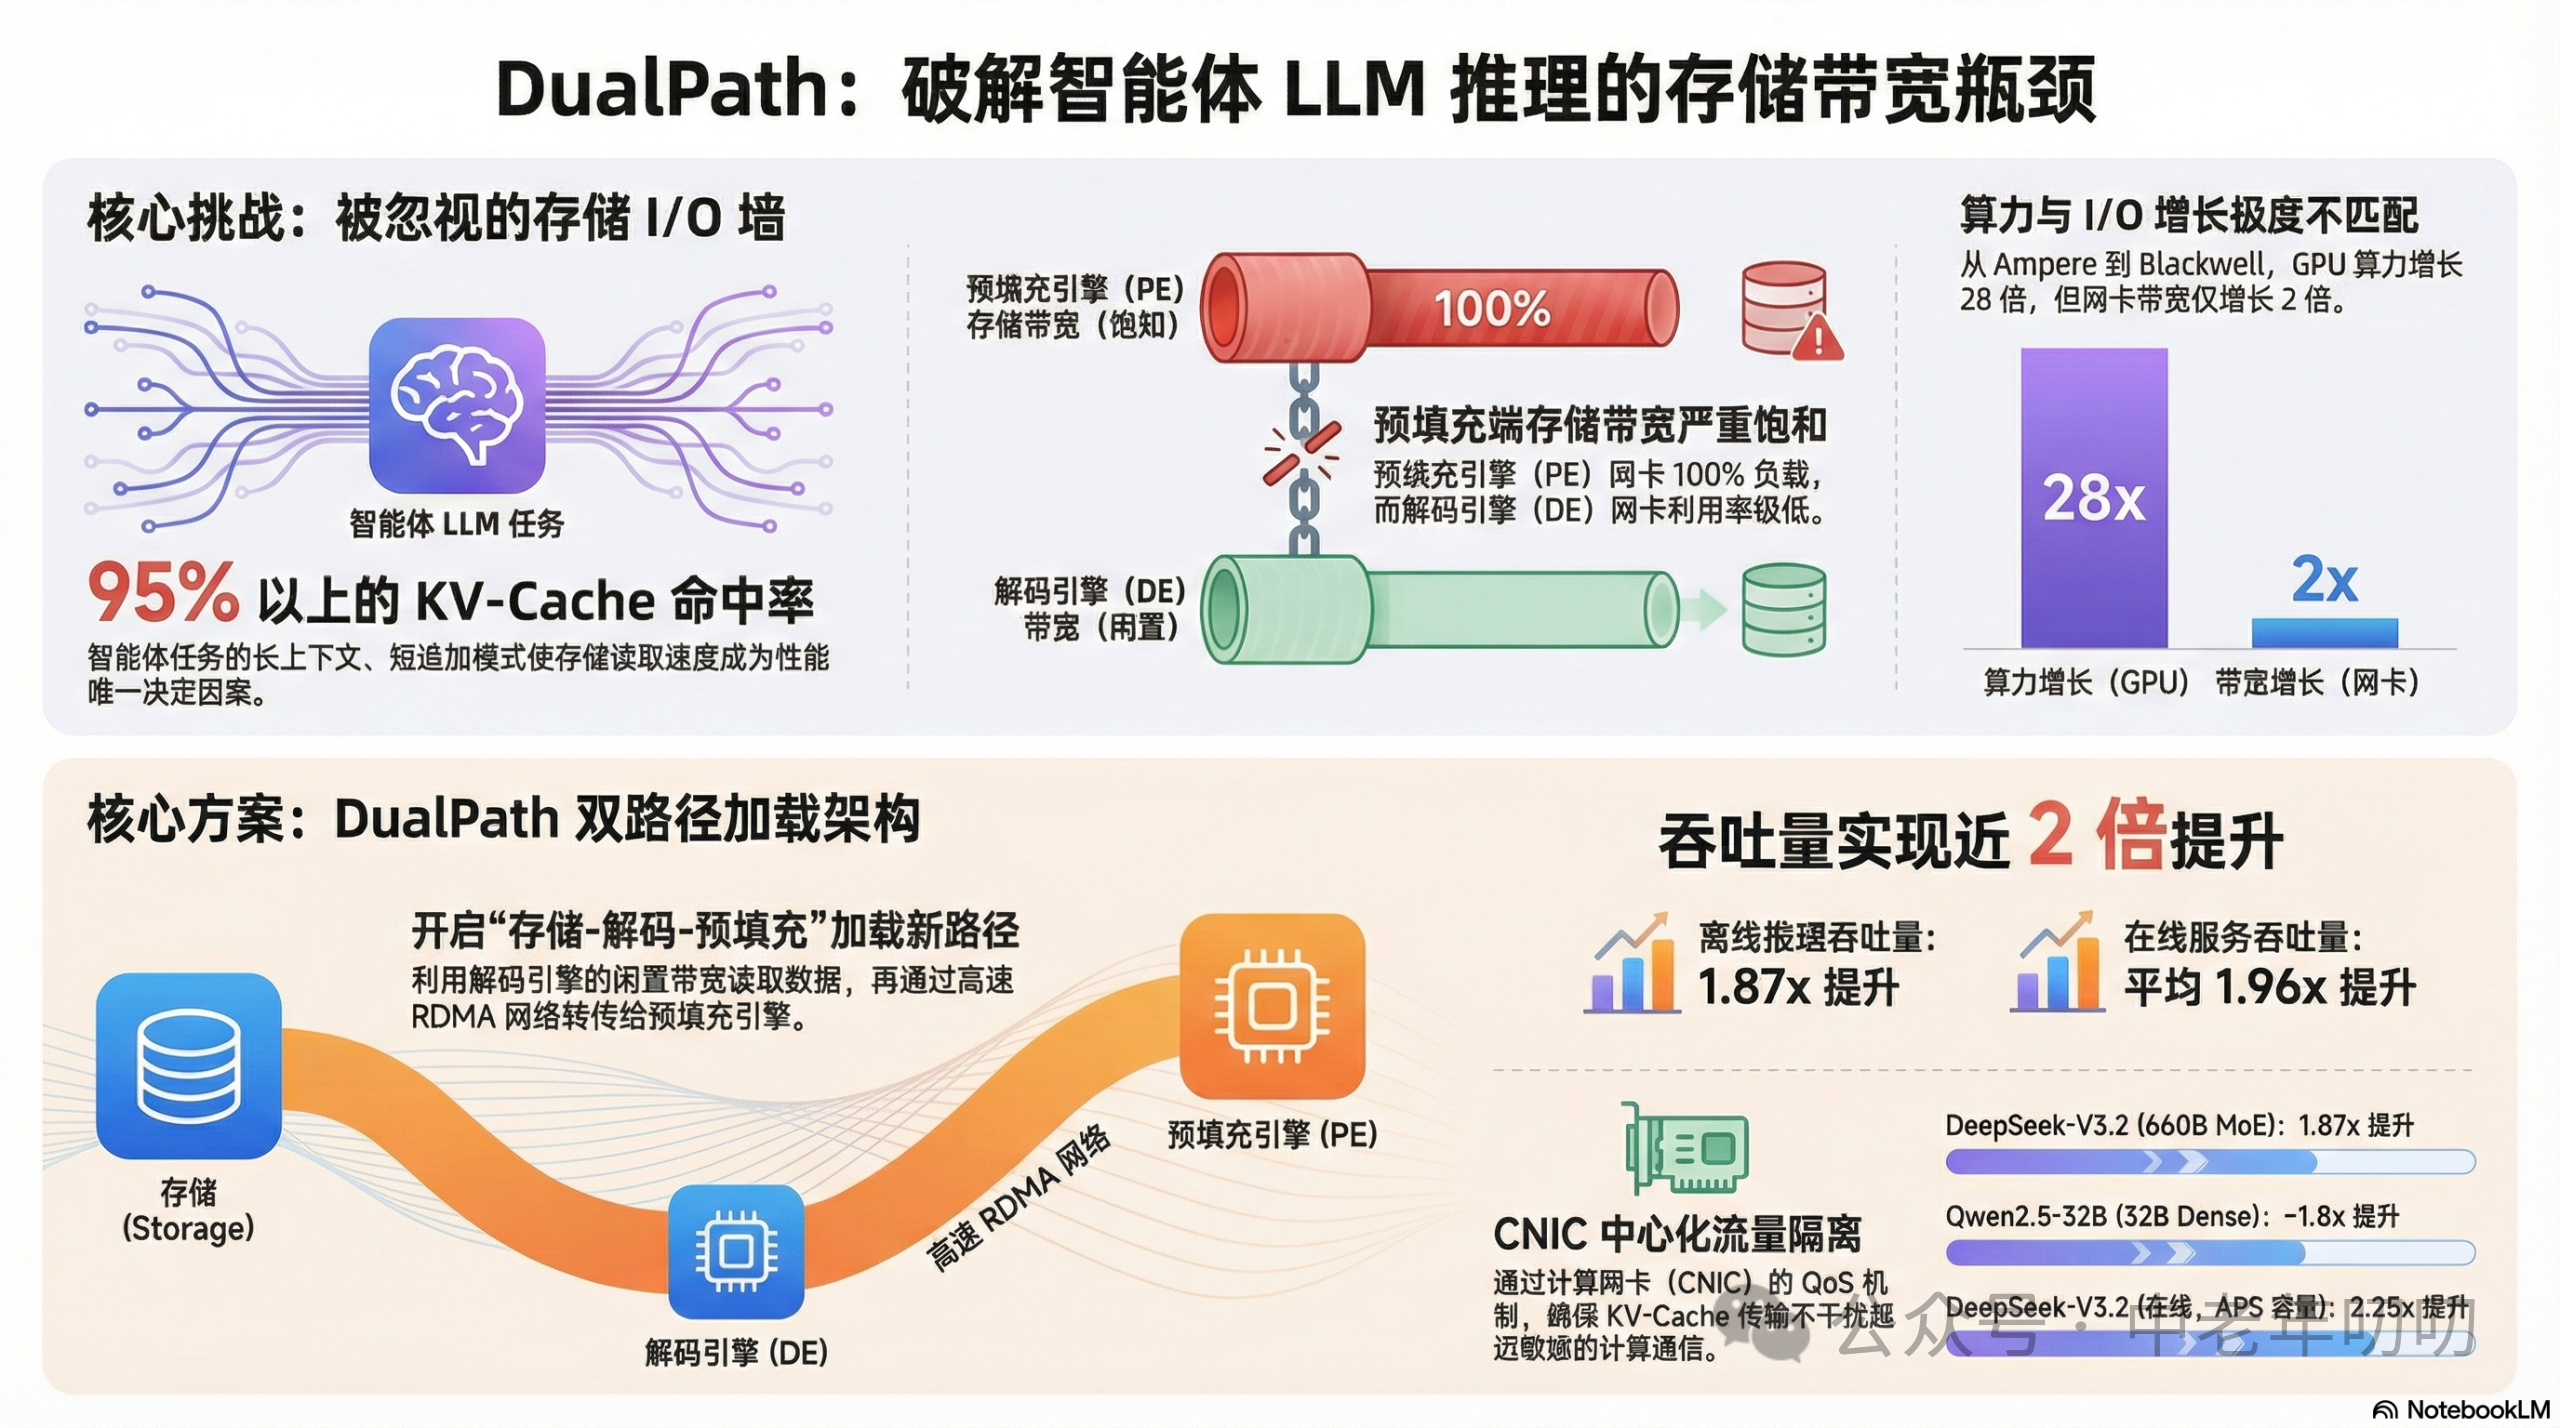
02. 💡 你的AI Agent为什么越跑越慢?
想象一下这个场景:你投入重金购买了顶级GPU集群,但当你构建复杂的AI Agent时,却发现推理速度越来越慢。明明计算资源已经拉满,为什么性能却遭遇”卡顿”?
这不是你的错,而是整个行业都在面临的共同困境。
AI Agent时代已经到来——从简单的单轮对话机器人,演进为能够自主规划、调用工具并在复杂环境下反复迭代的智能代理。但这种进化带来了一个意想不到的问题: 数据流向正在撞上一面看不见的墙。
03. 🧠 第一大发现:95%命中率背后的I/O陷阱
在Agent的交互逻辑中,模型深陷于”长上下文、短追加”的泥潭。用户指令、工具返回结果、思维链不断叠加,形成漫长的对话轨迹。
残酷真相 :95%以上的上下文在轮次间被重复使用,这意味着绝大部分Token都能命中KV-Cache。系统不是因为”算不完”而变慢,而是因为”读不过来”而卡顿!
即使是采用了先进MLA机制的DeepSeek-V3.2,其缓存计算比也达到了惊人的22GB/PFLOP。 推理的主导因素已不再是纯粹的逻辑计算,而是存储I/O。
04. ⚠️ 第二大发现:硬件进化的”不平衡”危局
既然瓶颈在带宽,升级硬件能解决吗?现实更加残酷——我们正处于一个”算力过剩、带宽短缺”的时代。
看看NVIDIA架构的演进数据:
- 算力 (FLOPS) 增长了28.8倍
- 网络/内存带宽 (NIC/HBM) 仅增长了2.0倍
- I/O与计算比率 : 下降了14.4倍
这种14.4倍的平衡性倒退形成了一面”加强版内存墙”。预填充引擎的存储网卡迅速饱和,强大的Tensor Cores只能被迫闲置,沦为”算力过剩”的牺牲品。
05. 🤯 第三大发现:被遗忘的荒原——解码引擎的带宽
在主流的PD分离架构中,存在一种隐蔽的不合理: “一边撑死、一边闲死” 。
- PE侧 (预填充引擎) SNIC被完全榨干,成为单点死穴
- DE侧 (解码引擎) 同等规格的存储网卡却完全闲置
这种资源错配让DE侧的带宽成为了”搁浅资源”或”黑暗带宽”,正是系统吞吐量低下的根本原因。
06. 🎯 核心方案:DualPath的”双管齐下”加载策略
DualPath提出了革命性的”存储到解码”路径,将存储I/O从单点瓶颈转变为”全局池化”资源:
6.1 🔧 带宽聚合
当PE需要加载海量KV-Cache时,不再单打独斗。闲置的DE伸出援手,利用自身存储带宽同步加载到DE内存中。
6.2 ⚡ 高速传输
加载完成后,数据通过比存储网络快得多的高速RDMA计算网络实时传输给PE。
6.3 🚀 算力释放
这种设计实现了带宽聚合,消除了单点饱和。在1/7 ≤ P/D ≤ 7/2的广泛配置范围内都能实现”Bottleneck-Free”
07. 📈 性能飞跃:不仅仅是数字的增长
具论文提及的实测数据显示,DualPath带来了质的飞跃:
- 离线推理 (RL Rollout) 吞吐量提升高达1.87倍
- 在线服务 : 在满足严苛SLO前提下,平均吞吐量提升1.96倍
最惊艳的是 : 在RL训练Rollout阶段,由于DRAM被卸载的训练状态塞满,增加内存几乎不可能。此时DualPath利用SSD存储带宽的策略显得尤为关键,表现几乎等同于完全消除I/O开销的”Oracle”状态
08. 🌟 结语:通往无限上下文的未来
在Agent范式席卷AI的今天, 数据的流向比计算的逻辑更值得重新审视 。DualPath的成功告诉我们:大模型推理的瓶颈已经从”脑力”转移到了”血管”。
随着模型交互迈向千轮量级、上下文突破百万甚至千万级,传统的存储边界正在瓦解。我们是否需要更彻底的”存储计算一体化”架构?
当I/O焦虑不再是阻碍,Agent进化的天花板将由你的想象力决定。 🚀
#AI技术 #大模型 #性能优化 #DeepSeek #Agent架构 #技术创新
09. 原文来源
原文发表于微信公众号“中老年叨叨”(2026年3月4日 07:30)。查看微信公众号原文。