前阵子用AI做量化回测,发现一个奇怪的现象:
回测的时候收益率吓死你,动不动年化百分之几十上百。
实盘跑起来,就是不赚钱——有图为证,截图为策略的回测数据,是不是吓人。
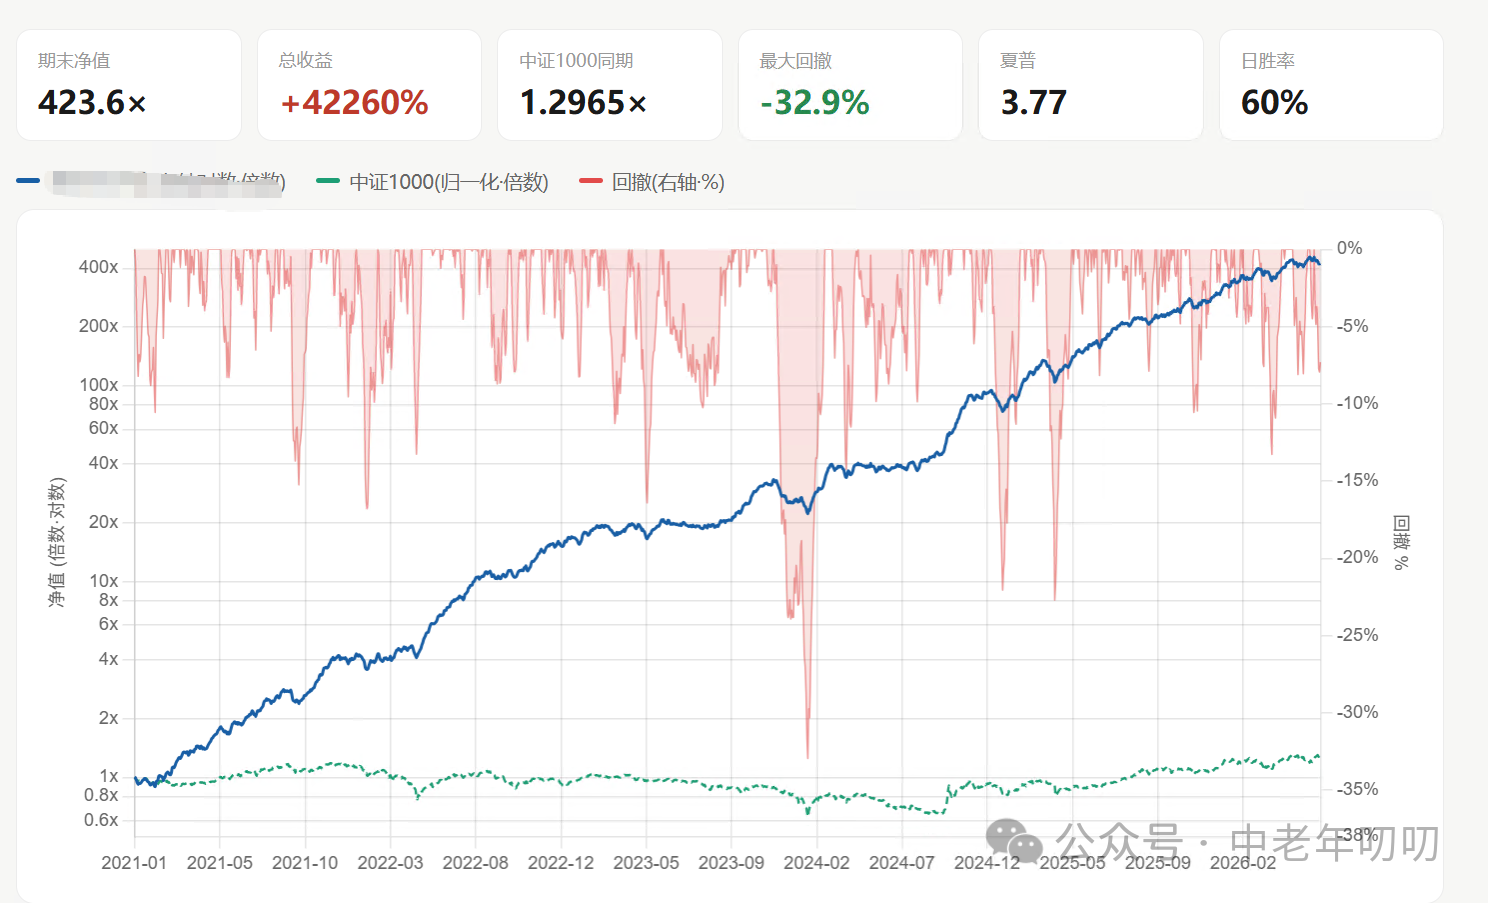
复核说明(2026-10-13):原稿未保存策略代码、历史股票池快照、数据版本、完整交易日志及费用口径。截图反映当时看到的回测结果,不能单独证明实盘收益、回测可复现,或幸存者偏差就是两者落差的唯一原因。下文保留原有思考过程;强结论应按“待检验假设”阅读。
我问一个做了十几年量化的朋友,他想了很久,最后说:我觉得根子在数据清洗上。
01. 但我想了很久,给出一个不同的答案:我认为根子在”历史是幸存者书写的”。
股市有句俗话: “股市反着买,别墅靠大海”。
很多人觉得这就是段子,瞎猫碰死耗子。
但我觉得,有没有一种可能,这句话不是瞎扯。
它背后是最朴素的幸存者偏差逻辑—— 大多数人往哪里挤,哪里就没机会。因为机会早就被先行者拿走了,后来者只能喝汤。
而AI,恰恰把这个效应放大了一百倍。
前几天AI给我推了一篇投资分析,说过去二十年A股最赚钱的股票是茅台,所以价值投资就是买龙头,拿着不动就能赚钱。
这话有错吗?
好像没错。
但你仔细想想: 现在你能看到茅台的成功,是因为它成功了,所以它才一直在指数里,一直在你的视野里。
那些二十年前也是”龙头”,后来破产退市了,你AI的训练数据里还能看到它们吗?
在只保留当前成分股或当前仍上市公司的数据集中,它们可能看不到;若使用完整的点时历史成分股与退市数据,也可以被纳入。需要查看实际数据源及回测代码,不能仅凭 AI 训练语料作判断。
这就是投资里的幸存者偏差—— 你看到的成功案例,都是已经活下来的。活不下来的,你根本看不到。
七十多年前二战,盟军统计飞回来的飞机,机翼和机身弹孔密布,发动机弹孔很少。
大多数人说:当然加强弹孔多的地方啊!
但统计学家瓦尔德说: 错,加强发动机。
理由很简单:发动机中弹的飞机,根本就飞不回来。你能看到弹孔,说明这儿中弹不影响它回来。
看不到弹孔的地方,才是真正要命的地方。
这个道理讲了几十年,大多数人也就当故事听了。
直到AI时代来了,我才发现:
这个七十多年前的老道理,在当下比以往更重要。
02. AI训练数据,本身就是个巨大的幸存者偏差
现在大家都说,AI好啊,大数据全样本,比人看得准。
但: AI的训练数据,天生就是被幸存者偏差污染的。
什么东西会进AI的训练数据?
- 成功的公司——会被报道、会出书、创始人会到处演讲
- 赚钱的策略——会被人写文章、会被总结成”宝典”
- 活下来的技术路线——会有大量文档、大量教程、大量讨论
什么东西不会进训练数据?
- 死掉的公司——破产清算,网站都没了,谁会给你写经验总结?
- 失败的策略——亏钱了,大家都闭嘴了,谁会到处宣扬?
- 走不通的技术路线——死了就是死了,连讨论的必要都没有
所以AI学到的是什么?
可能偏向“幸存者写的教科书”,具体偏差程度取决于样本的收集、保留和过滤方式。
它只能告诉你, 活下来的公司都做了什么 。
它没法告诉你两个关键信息:
- 1. 100家做了同样事情的公司,99家死在哪里 ——这些死者不会出现在数据里
- 2. 正因为所有人都看到了这个”成功路径”,所以所有人都挤进来了 ——超额收益早就被摊薄了
回到开头的问题:为什么回测赚爆,实盘不赚?
幸存者偏差可能是一种解释,但原稿材料尚不足以证明它是原因,更不能排除其他原因。
如果回测误用当前指数成分股或当前上市股票构造历史样本,退市和被剔除的股票就可能被遗漏;使用点时历史成分股的数据源则未必如此。原稿没有记录具体数据源及取样代码,这一步需要重新核查。
AI在已经筛过一遍的样本上找规律,找到的当然都是”幸存者特征”,不是”盈利规律”。
更要命的是——等到你用这个规律去买股票,那些”幸存者特征”早就被市场定价了。你赚不到超额收益。
澄清一个常见误解: 不是让你故意去买那些九成公司都死了的行业,那叫找死。
我的意思是:
当所有人都被AI带着,挤到”成功路径”上去的时候,那个地方的机会早就没了。
而那些被AI打上”高风险、成功率低”标签的地方,恰恰因为没人敢去,竞争没那么激烈, 剩下的玩家反而能拿走全部利润 。
03. 那真正的超额收益在哪里?
有可能就在AI没推荐的地方。
AI说:“这个行业过去十年都是下跌的,大多数公司都破产了,所以别碰。”
但你反过来想:
正是因为过去十年大多数公司都死了,活下来的少数几家, 行业集中度一下子上来了,利润开始向头部集中 。
正是因为所有人都不看好,都被AI的数据结论吓唬住了, 估值才压到了地板价 。
这个时候,反而才是真正的机会。
不是让你瞎买垃圾股——是说, AI的数据偏见,会让它系统性地低估”洗牌后行业”的机会 。
我准备强迫自己养成一个新习惯: AI没覆盖到的方向,我越需要花时间研究。
不是我故意跟AI对着干。
是我知道,AI的数据里,那些被人遗忘的方向,本来就是信息最少的。
信息最少的地方,才存在真正的认知差。
认知差,才是超额收益的来源。
04. 个人发展上,AI说”这个赛道饱和了”,你信吗?
推到个人找工作、创业,同样成立。
现在很多人找AI做职业咨询:
“AI你帮我分析一下,哪个赛道有机会?”
AI吐出来的结论,往往是这样:
人工智能赛道好,过去五年增长300%,一堆公司融资,所以你应该进AI。
传统制造业不行,增长只有2%,一堆企业倒闭,所以别进。
这个逻辑对吗?
对一半,错一半。
AI说的没错,AI看到的数据就是这样——AI赛道成功案例多,传统制造业失败案例多。
但你反过来想:
正因为所有人都听AI的,都往AI赛道挤,现在AI赛道卷成什么样子?
一个应届生岗位,几百人抢,进去就是一颗螺丝钉,你能分到多少蛋糕?
反过来,传统制造业真的没机会吗?
正因为过去十年很多人都走了,留下来的人,反而不愁没活儿干。
我认识一个朋友,十年前跑去做工业阀门,所有人都觉得他傻。
现在呢?
老师傅都退休了,年轻人没人愿意干,他一个项目的利润,顶互联网公司一个部门。
这就是诡异的地方:
AI告诉你”机会在这里”,所有人都冲进去了,机会就没了。
AI告诉你”那里没机会了”,所有人都走了,机会反而出来了。
为什么?因为AI的数据就是这样——它只有幸存者的数据,它看不到”没人去”本身就是一个优势。
05. 为什么AI越发达,我们越要懂幸存者偏差
我最近越想越觉得,幸存者偏差这个概念,简直就是为AI时代量身定做的。
AI的本质是什么?是归纳。
它从大量历史数据里归纳出规律,然后告诉你该怎么做。
但归纳法天生就有一个bug:
它只能归纳已经发生过的事情,它只能归纳已经活下来的事情。
那些没发生的、没活下来的、没人尝试过的,它归纳不出来。
但商业世界、投资世界、人生,从来都是:
- 真正的大机会,都在归纳法之外
- 真正的超额收益,都在共识之外
- 真正的创新,都在现有数据之外
那是不是说,我们就应该完全不听AI的?
倒也不是。
我的看法是这样:
AI给你的是”共识答案”,你要用幸存者偏差给这个答案打个补丁。
AI说:这个好,你应该去。
你问自己一句: 是不是因为它好,所以所有人都看见了,所以机会已经没了?
AI说:这个不好,别去。
你问自己一句: 是不是因为它不好,所以所有人都走了,所以反而剩下了机会?
这一个补丁,就够了。
06. 最后说一句
七十多年前,瓦尔德对着一堆弹孔说出了那句反常识的话:
“看不见的弹痕,才最致命。”
今天AI给了大家一堆”看得见的规律”。
我们得记住:
AI没告诉我们的,往往比AI告诉我们的更重要。
AI越发达,大家越依赖AI给的答案。
你越能看到AI看不见的地方,你就越有竞争力。
这个七十多年前的老道理,不会过期。
因为只要有人、有数据、有筛选,幸存者偏差就永远在那里。
而你,能不能看到那些”看不见的弹孔”,才是真正拉开差距的地方。
你怎么看?你在投资或者工作中,遇到过哪些幸存者偏差的例子?评论区聊聊。
📎 参考来源:
- 《统计与真理》,C·R·劳
- 二战飞机弹孔经典案例(瓦尔德,1943)
- 个人投资观察与交流记录
⚠️ 本文仅为观点交流,不构成任何投资建议。
07. 回测核验与复盘记录
复盘日期:2026-10-13。原判断是“幸存者偏差解释了回测与实盘的落差”;目前只有原文截图与个人观察,没有同一策略的可复现记录,结果应记为尚不能判断。
重新测试时,应固定策略代码、数据版本、回测起止日、训练和样本外区间,并逐项核对以下条件:历史成分股与退市处理、分红复权、停牌和成交约束、调仓时点、滑点与手续费、未来数据泄漏。至少对比“当前成分股回填”和“点时历史成分股”两组,再逐步加入交易成本和样本外数据;把策略失效、拥挤交易与执行偏差作为竞争解释。没有日志时,不把图中收益当成可复现绩效,也不能用这次修订声称原假设已被验证。
08. 原文来源
原文发表于微信公众号“中老年叨叨”(2026年6月28日 17:07)。查看微信公众号原文。