话题起源:
最近Claude和Codex批量封号严重,我自己的也不幸被咔嚓。辛辛苦苦养的Claude Code和小龙虾几乎要被活活饿死,吃不到细粮,暂时吃点粗粮顶一下。
那次替换工具后的主观体验差了很多:原本我以为几个小时能完成的事,反复修改,最终用了约 3 天。这是个人回忆;原稿没有保存相同任务在两套工具上的版本、提示和日志,不能把这个时长差当成受控测量。
阅读边界(2026-10-13):下文是写于 2026 年 3 月的工程感受和模型选型判断。模型能力、价格、可用性和合规条件都会变;涉及“某类模型必然更强”“多 Agent 几乎无效”的表述,需要用相同任务与验收条件重新测试。
跟群里几个朋友交流了一下,几乎都有同感:
01. 跑分通胀:大模型界的“刷题家”现象
先聊聊“应试教育”。
在AI界(其实各行各业都一样,都有评测),测试集(Benchmarks)本意是作为衡量模型能力的尺子。然而,当厂商们发现市场只认榜单排名时,这把尺子就变成了考试卷。为了拿高分,最简单的办法不是提升模型的“大脑智力”,而是把测试题库塞进训练数据里刷题。
这就是所谓的“做题专家”。类似一个非英语母语国家人在雅思考试中拿了8.5分,超过了90%的英国人。但不一定代表他真的能和英国人谈笑风生,而是因为他背下了过去十年的所有真题和预测题。一旦你要求他去伦敦的餐馆点一次“蒸溜爆炒煎炸煮”大餐,那“应试英语”的无力感就会瞬间暴露。
目前的某些大模型,正处于这种“高分低能”的尴尬期。在标准的编程测试集(如 HumanEval)上,它们表现惊人;但在处理具有独特业务逻辑、多种库依赖的真实工程时,由于没有“标准答案”参考,它们往往会暴露出推理深度的不足。
02. 与 1.01 的生死线:“人海战术”来一套?
另一个误区:质不够,量来凑。
其实这也是过去几十年我们吃尽人口红利时期的常见套路。那么是不是可以类推:如果一个模型不够聪明,我可以用“量”来弥补?比如多轮对话引导,或者最近刚开始流行的“Harness”约束(话说,我搜了一下这个词的本意,各位有兴趣可以淘宝上搜,结果有点辣眼睛)或者搞一套“多Agent协作”,让几个模型互相检查?
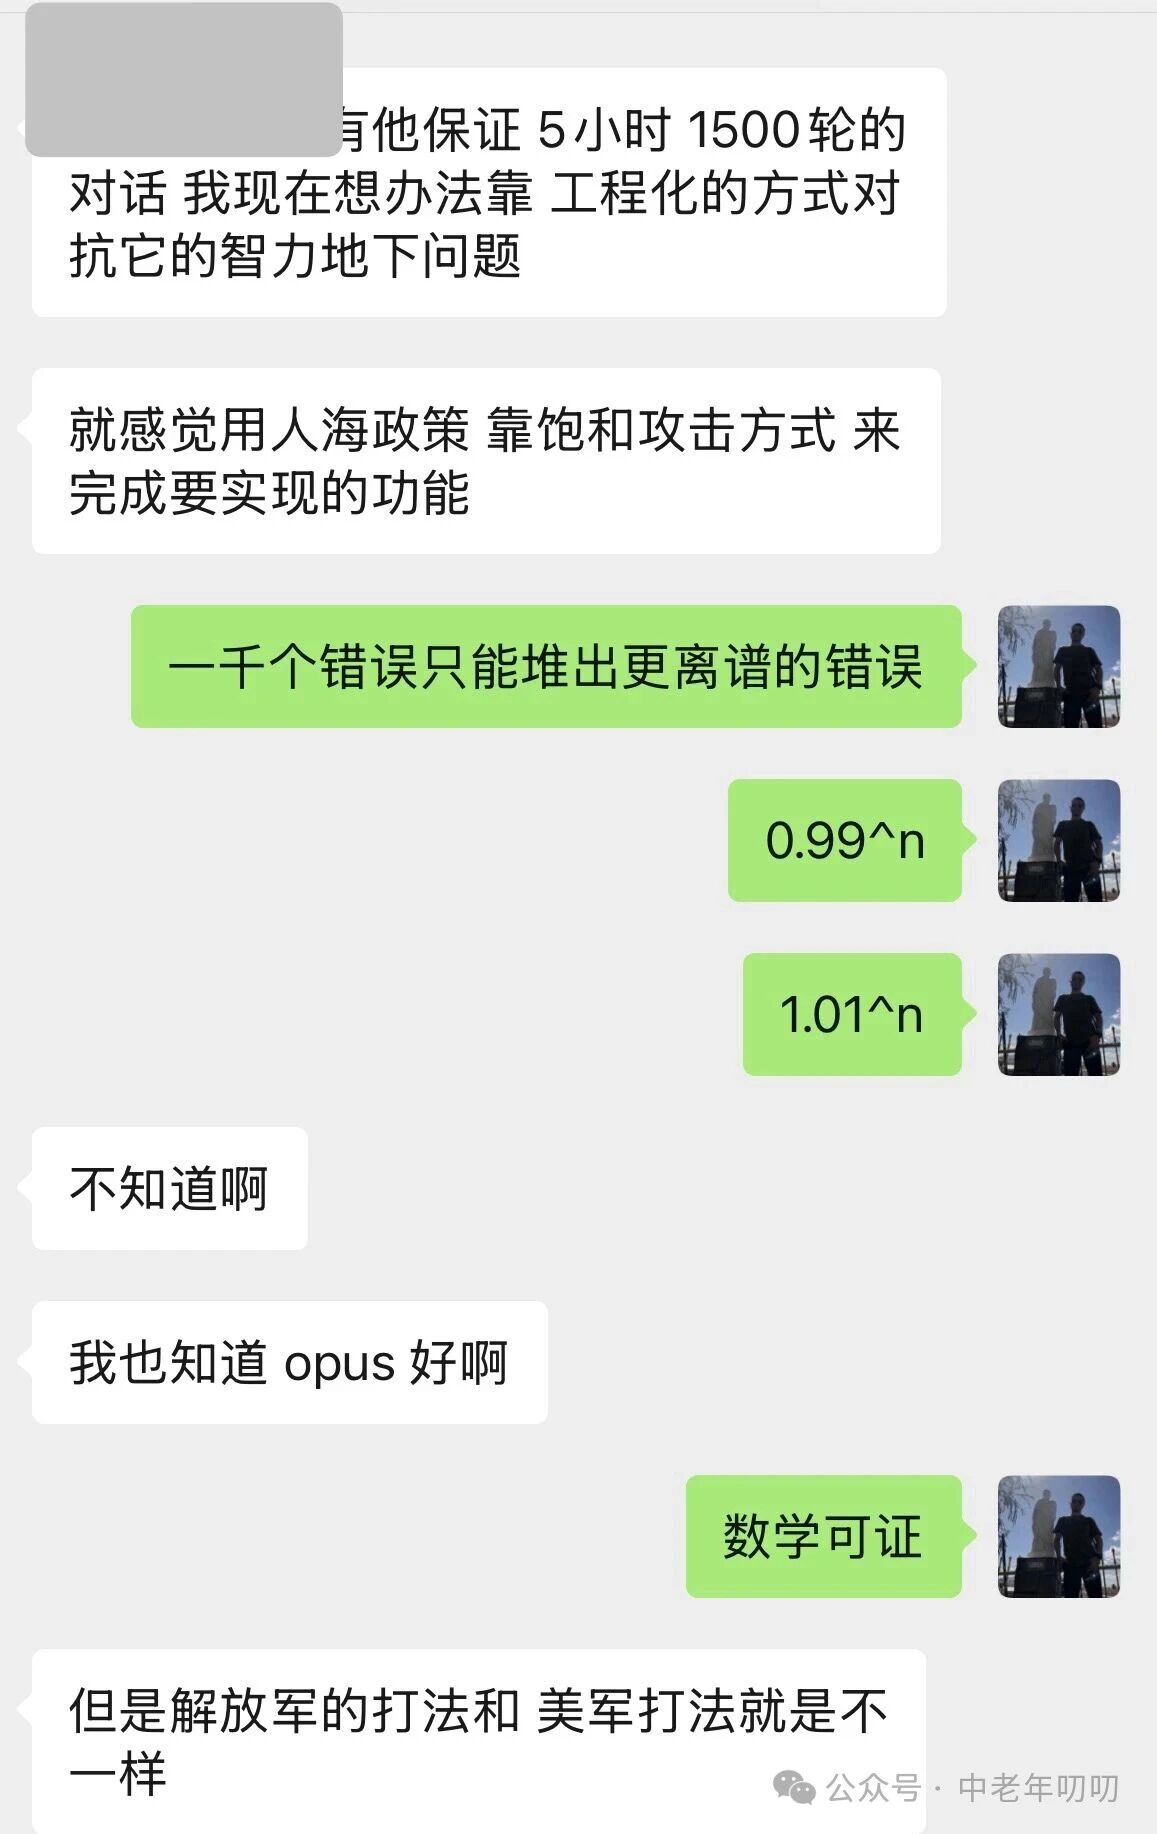
在我当时遇到的逻辑编码任务里,我怀疑这类办法未必能补足底层模型能力;它们在其他任务上的效果仍需分开评估。
我的感觉就像0.99^n vs 1.01^n。在编程这种容错率极低的任务中,模型的能力只要比低那么一点点(0.99),随着任务复杂度的增加(n次迭代),最终结果会趋向于崩塌(0.99^100=0.366)。
写代码不是搬砖,而是盖摩天大楼。地基错了一厘米,到了一百层可能就斜出去几十米。如果用的模型在逻辑底层有缺陷,每通过对话“约束”它一次,实际上是在打一个补丁。补丁打得越多,系统的熵增就越剧烈,最后,为了让AI跑通一段逻辑,花的精力甚至超过了自己手写。
所以,对于俺们码农来说,我当时的感受简单粗暴:“买得到的最好的模型”可能是综合成本更低的选择,但前提是把等待、人工审查、返工和调用费用一起计入,不能只比较单次 API 价格。
03. 饱和攻击的幻想:多Agent互搏
去年开始,Claude引入了Agent和Sub-Agent协作的概念,今年初又发布了蜂群,于是也有同学幻想着是不是可以通过周伯通的“左右互搏”打败“九阴真经”。
但实际情况是,Claude的多个Agent或蜂群的上限天花板高度依赖于底层那个“大脑”的推理能力底座。如果底层模型对语义的理解以及后续推理有偏差,那么Agent之间的协作就会变成一场公司团建常玩的那个“传声筒游戏”。第一个Agent产生了一个微小的理解偏差,第二个Agent在此基础上进行了推演,到了第五个Agent那里,输出的结果可能已经和你的原始需求南辕北辙。
这种“饱和攻击”在处理简单的自动化任务时相对有效,但在面对深度的、需要严密逻辑闭环的编程或数学任务时,它无法替代那个最核心的、单点逻辑能力极强的“更强大脑”。
像极了大学宿舍里那个经常不上课,从来不刷题,每次考第一的上铺学霸兄弟。
04. 视角切换:其他模型的价值在哪里?
说了这么多,次一点模型是不是就该自动去死?显然不是。如果我们跳出“追求极致编程能力”的单一度量衡,会发现战场其实很大。
首先是“本土适应性”。就像一个虽然英语一般但深谙中国职场文化的员工,在处理中文公文、理解国内复杂的办公流程、对接具有中国特色的软件生态(如钉钉、飞书、各种国产数据库)时,国产模型展现出的“语义直觉”往往比 GPT 这种远在硅谷的模型要好得多。
其次是“安全边界”。这是一个无法绕过的硬指标。对于许多保密单位的开发者来说,性能是0,安全才是前面的1。开源模型支持私有化部署,能跑在防火墙内,甚至能针对公司内部的陈旧代码库做专门微调。这种“贴身伺服”的能力,是云端模型无法提供的。
05. 结论:我们该如何做选择?
如果你是一名追求效率的开发者,或者正在处理一个高难度的从零到一的创造性项目,那么我的建议是直接买目前市面上你能接触到的、逻辑推演能力最强的模型(哪怕它需要你折腾🪜或者支付更高的费用)。在这个领域,0.99 的替代品是没有意义的。
如果你是一名企业架构师,正在考虑如何为公司数千名员工提供 AI 辅助工具,还需要把权限、隐私、集成和运维成本纳入测试;模型推理能力只是其中一项。
如果是保密单位,陈年屎山代码巨大,主要目标是现有系统的补丁和改造,那么你的目光也许应该投向那些性价比高、支持私有部署、且在内网算力约束下表现稳健的国产开源模型。
回到标题:别看广告,看疗效——别看排名,看你的代码直接反馈。真正的能力不在榜单里,而在那行自动生成的代码是否真的读懂了你的要求。保持清醒的“用户视角”,比被厂商的“跑分卫星”带着跑要重要得多。
06. 如何复测这次体验
复盘日期:2026-10-13。原判断是“模型能力差异导致同一工作从几小时变为三天”。目前缺少原始仓库基线、模型版本、运行日志和验收记录,尚不能确认耗时差来自模型本身,也可能受任务范围、工具配置、等待时间或人工改动影响。
下一次选择一个可公开、可复现的任务,固定起始提交、需求和测试;分别记录模型与工具版本、提示、等待与重试、人工修改的文件和行数、测试通过情况、人工审核结论及调用费用。用同一验收条件对照,区分“生成速度”“交付总时间”和“安全检查结果”。若原记录找不回,新实验只能说明新条件下的表现,不能倒推旧体验的具体成因。
07. 原文来源
原文发表于微信公众号“中老年叨叨”(2026年3月30日 20:14)。查看微信公众号原文。