01. 红队实战:Github 1.1K Star,一个AI写报告,四个AI来拆台
投资红队框架前文全员看多,股价腰斩:你需要建立投资分析的红队——三层六角度,从贝叶斯到博弈论到常识。但框架是纸上的,思维在脑海中,没有手上的趁手工具。
这两天逛GitHub,发现一个好玩的Claude Code skill:Hyper Research。一份研究报告,四个AI围上来从不同角度攻击它,攻击完又补了一轮搜索,补完再攻击。16步流水线,4个并行评论员围着你的研究报告挑刺。这恰好是我前两天写的红队思维的AI工具实现,于是第一时间装了研究一下。
AI SaaS ToB行业产品老兵,创业者,欢迎关注并理性讨论。
02. 前文回顾:红队到底在做什么
第一篇全员看多,股价腰斩:你需要建立投资分析的红队的核心是三层红队逻辑:
- 第一层, 数字会说谎 。
- 第二层, 人会自利 。
- 第三层, 市场在定价 。
第二篇书接前文:解禁前17天,SpaceX突然有了520亿AI大单的核心是动态跟踪和持续监控
当时文章发完,就有人问:这套框架不错,但每次人肉动脑子跑一遍容易错漏,而且每个不同案例会被忽略的信息角度都不一样,有没有一个东西,能把红队流程自动化?
截至目前,我认为这个Hyper Research就是。而且它的设计思路,恰好跟红队框架一一对应——还比我的框架多了一个维度。
03. Hyper Research:一支自动化的AI研究红队
Hyper Research是GitHub上一个开源项目,作者Jordan Gibbs( https://github.com/jordan-gibbs/hyperresearch )。它的核心功能是把Claude Code变成一个深度 找茬Agent ,用16步流水线把一个研究报告充实变成一份经过对抗性审查、每条引用都可追溯的研究报告。
完整的16步框架流程:
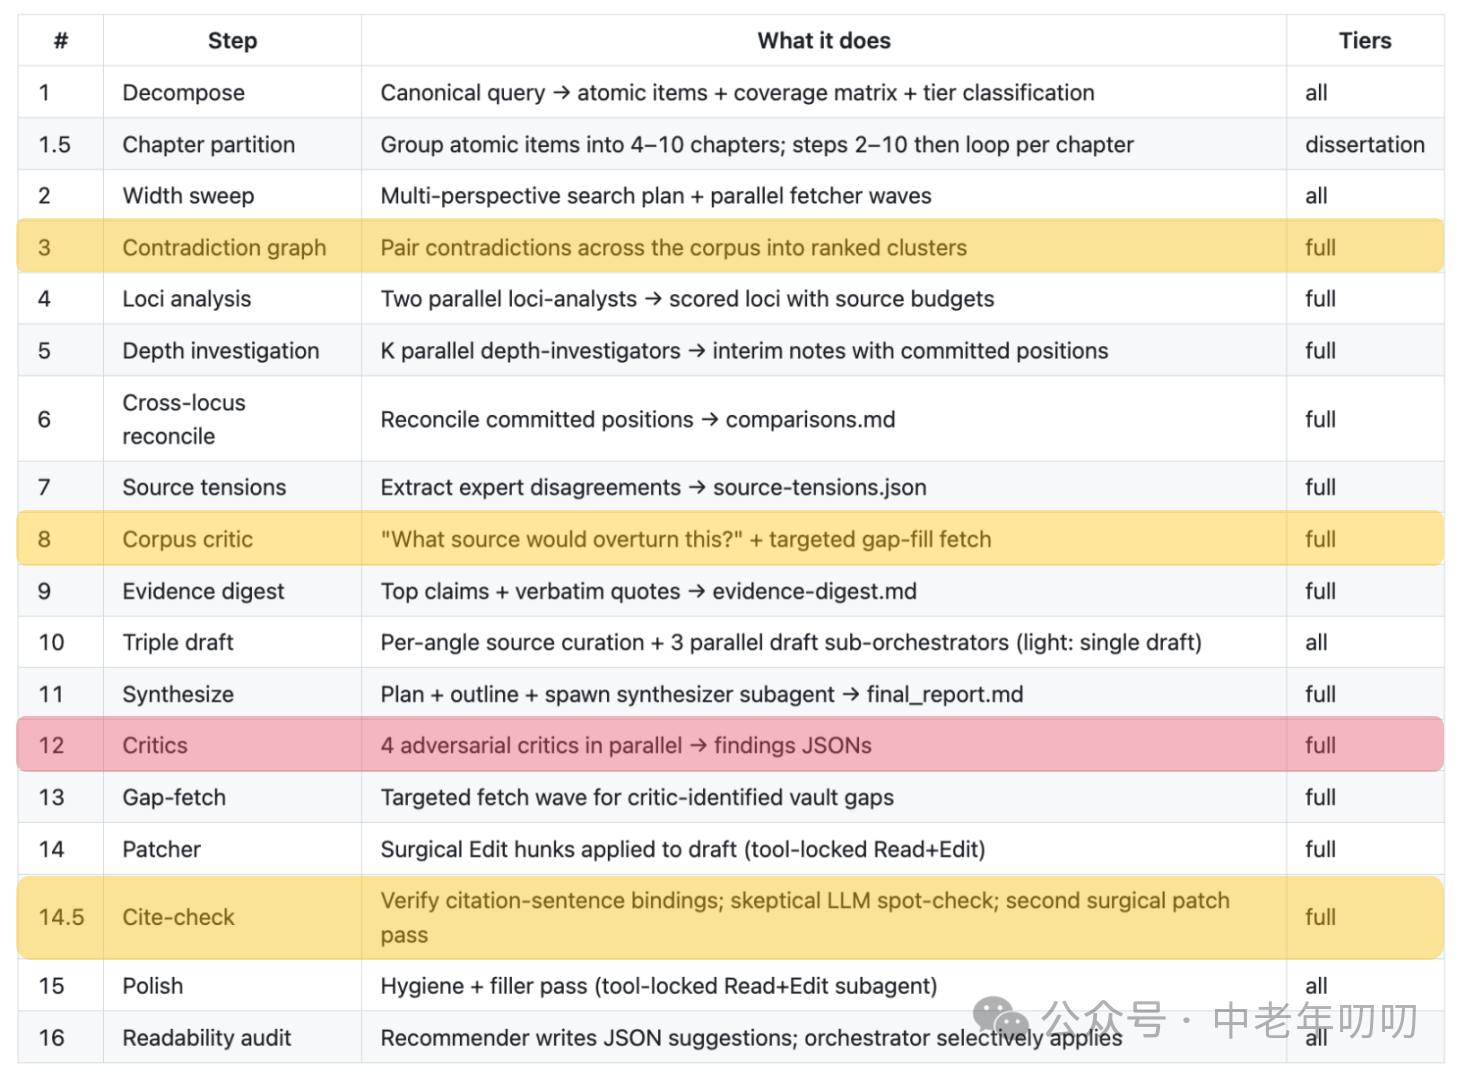
橙色步骤 = 红队相关(步骤3第一层、步骤8第二层、步骤14.5第三层)
红色步骤 = 红队核心(4评论员并行攻击)
其中跟红队思维框架直接相关的核心步骤:
步骤3:矛盾图谱(Contradiction Graph) ——不是收集所有说同一件事的来源,而是主动寻找不同来源之间的互相矛盾,然后聚类排名。这恰好是红队第一层”数字会说谎”的AI版本:不只看数字,看数字被放进了什么框架;不只看来源说了什么,看来源之间在吵什么。
步骤8:语料批评家(Corpus Critic) ——在草稿写出来之前,先问一个反事实问题:“什么样的信息会推翻当前的结论?“然后针对性地去搜索那些信息。这比人类红队更彻底——人类红队也会有确认偏误,但AI批评家被明确编程为”找反证据”。
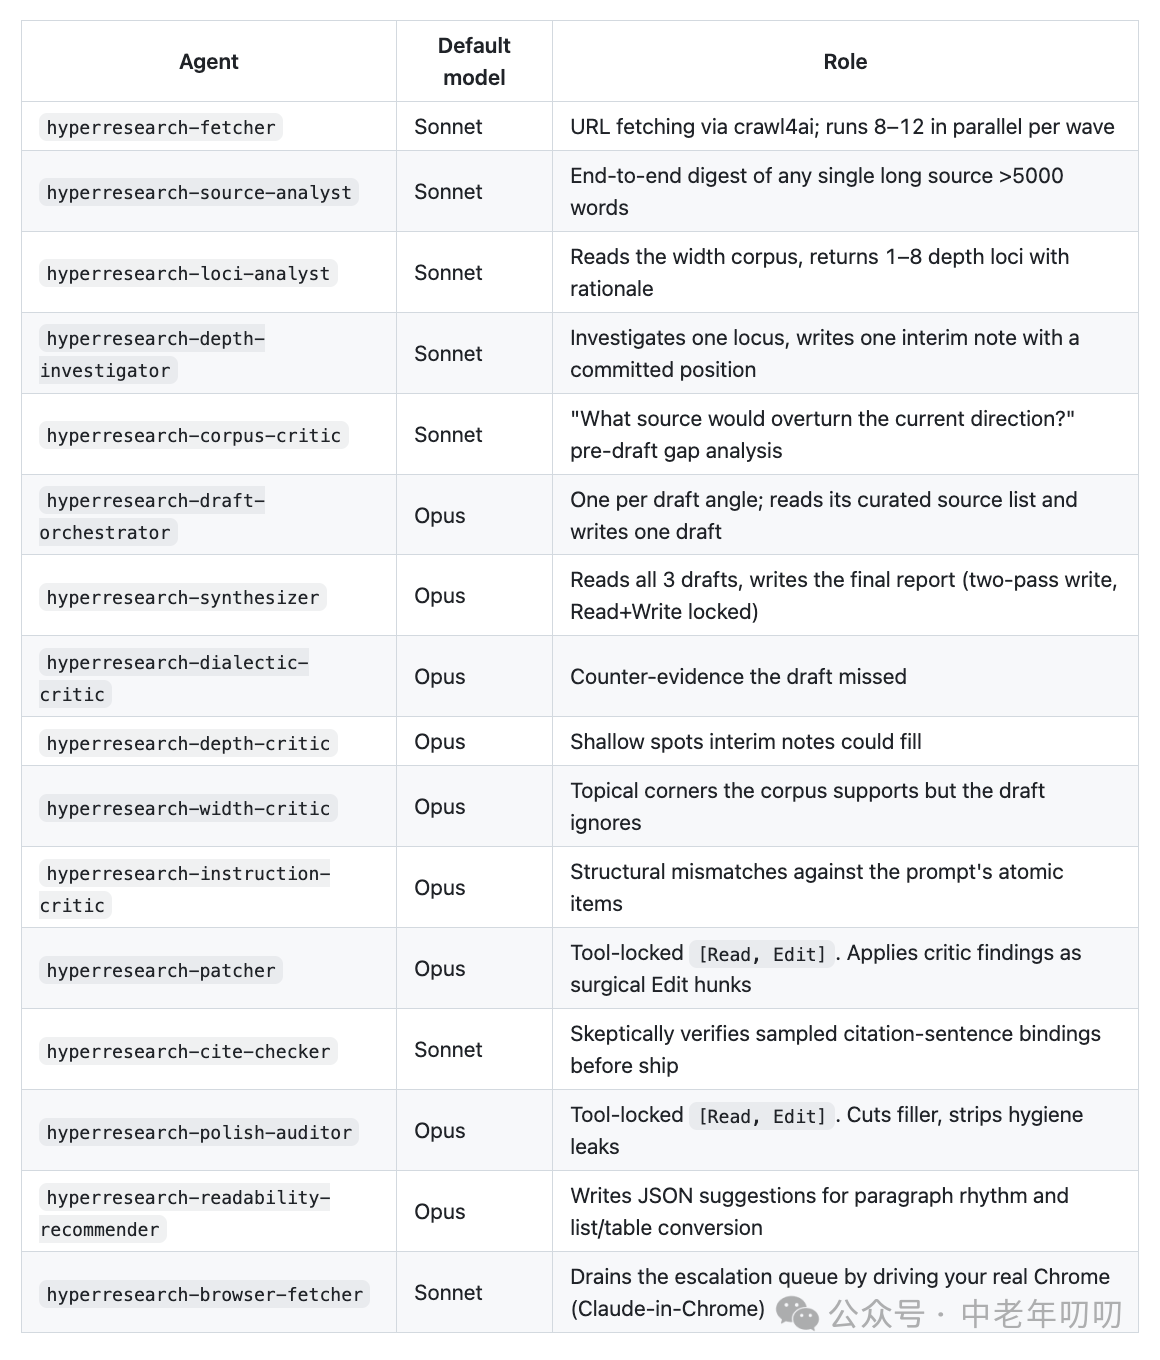
步骤12:四个并行评论员(4 Parallel Critics) ——这是最红队的部分。草稿写完后,四个AI评论员同时从不同角度攻击它:
- 辩证评论员:找草稿遗漏的反证据
- 深度评论员:找浅薄的分析点
- 广度评论员:找草稿没覆盖的话题角落
- 指令评论员:检查草稿是否偏离了最初的研究问题
步骤14.5:引用验证(Cite-Check) ——逐条验证每个引用是否真的支持它声称的观点。如果发现引用的原文跟草稿里的表述不一致,直接标记为硬错误。这个机制直接对应红队框架里”不看研报结论,看分析师的激励机制”——不只看引用列表有多长,看每条引用是不是真的在说它被声称在说的东西。
步骤12的组合拳,加上步骤3的矛盾图谱和步骤8的语料批评家,本质上就是一支完整的AI红队。 它不比你更聪明,但它的工程化执行能力远超人类——不会因为”大家都这么写”而放弃质疑、不会跳过任何一条该查的反证据、不会在第四步之后开始偷懒。
04. 从三层到四层:Hyper Research解决了工程化问题。
我的投资红队框架是三层:数字(第一层)→ 人(第二层)→ 市场(第三层)。
把Hyper Research的机制映射进去不仅覆盖了这三层,而且多了一个最重要的工程化层。
第一层对应:矛盾图谱 + 引用验证。 红队问”数字被放进了什么框架”,Hyper Research问”这些来源之间在吵什么”和”每条引用真的支持它被声称的观点吗”。同一个逻辑——不质疑表面数据,质疑数据的呈现方式和来源质量。
第二层对应:来源独立性审计。 Hyper Research有一个”独立性审计”机制:自动聚类衍生副本和转载。五篇转载同一篇新闻稿,在报告中只算一票。这在红队框架里对应的是”18个分析师不是18次独立判断,是一次判断被复制了18次”。Syndication doesn’t count as consensus——这是同一句话的两种表达。
第三层对应:知识库复用 + 撤回检测。 红队说”市场在定价”——债券利差、历史基准是真金白银的信号。Hyper Research对应的是两个机制:每次研究的来源永久保存在可搜索的知识库里,下次研究复用;每篇论文的撤回状态在每次输出前重新检查,今天撤回的论文明天就拦截。在AI研究的语境下,“市场”就是知识库——积累的、可验证的、持续更新的信息来源。
最重要的是第四层:工程化。 人类红队受限于精力、注意力、确认偏误。你让一个人做4个不同角度的批评,第三个角度可能已经开始敷衍。但Hyper Research把红队流程变成了一套可重复、可并行、可验证的工程系统——四个评论员并行跑,每个都从自己的角度彻底检查;16步流水线每一步都有独立工作空间和明确产出物;引用验证不是”抽查”而是每一条都过。人类红队可以做深度,但做不了这种”工程化的系统覆盖”。
这正是红队思维的AI升级版: 不是替代人类判断,是让人类把精力花在AI也查不到的地方。
你可能注意到了——我没有提”AI红队比人类红队更聪明”。因为这不是事实。AI红队比人类红队强的地方不是智力,是工程化能力。它不会在第三步之后开始偷懒,不会因为前三个来源都说了同一件事就跳过第四个。它唯一的超能力是: 把”找茬”变成了一套可重复执行的工程化流程。
05. 实操:5分钟搭一支你的AI红队
说了这么多,具体怎么用?
安装: 一行命令。
pip install hyperresearch && hyperresearch install要求Python 3.11-3.13,Claude Code已安装。装完后在Claude Code里输入/hyperresearch <你的研究问题>就行了。
三级分层: Hyper Research有三种运行模式,按你的需求选:
| 级别 | 时间 | 来源数 | 适合场景 |
|---|---|---|---|
| Light | 30-40分钟 | 55-80 | 事实查询、调查、对比 |
| Full(默认) | 1.5-2.5小时 | 100-130 | 深度分析,完整对抗性审查 |
| Dissertation | 4-8小时 | 300-450 | 分章报告,25K-80K字 |
大部分日常研究用Light就够了。需要做决策的研究——比如投资尽调、竞品分析、行业判断——开Full。写书或者做系统性学术研究才需要Dissertation。
配置建议: 默认配置已经够用。如果想调高深度,一行命令:
hyperresearch profile use premier知识库: 这是Hyper Research最被低估的功能。每次研究的所有来源自动保存到research/notes/,SQLite索引,支持全文搜索和语义搜索。下次研究相关话题时,它会先搜知识库再搜外网。越用越聪明——这是AI红队的”复利效应”。
踩坑提示:
- 第一,它使用了Claude的SubAgent机制,同时跑的子智能体一堆,token消耗不小。Light模式大概几十块,Full模式大概率跑到百把块,至于Dissertation则去到大几百。建议用各家平台提供的Coding Plan中DeepSeek-V4-Pro[1M]模型。
- 第二,引用验证虽然严格,但不能替代你自己的判断——它验证的是”出处是否支持这个说法”,不是”这个说法是否成立”。
- 第三,跟所有AI工具一样,最终决策是你的。
- 第四,建议把每次研究的知识库路径统一管理——同一个话题的多次研究可以共享知识库,避免重复抓取。
06. 红队思维的终局:从投资到AI研究,再到所有判断
前文说:投资的第一性原理不是”买到牛股”,是”保住本金”。红队不帮你找到下一个十倍股,它帮你避开下一个腰斩股。
把这个逻辑平移到其他研究:研究的第一性原理不是”写出漂亮的报告”,是”不被骗”。红队不帮你写出论证完美的文章,它帮你识别那些”看起来完美但 一面之词 “的结论。
同时,从哲学的层面上讲:Hyper Research也需要被红队思维对待:而且其实Hyper Research的作者在README里就写了:“It doesn’t replace your judgment on which sources matter. The agent picks, you steer.”
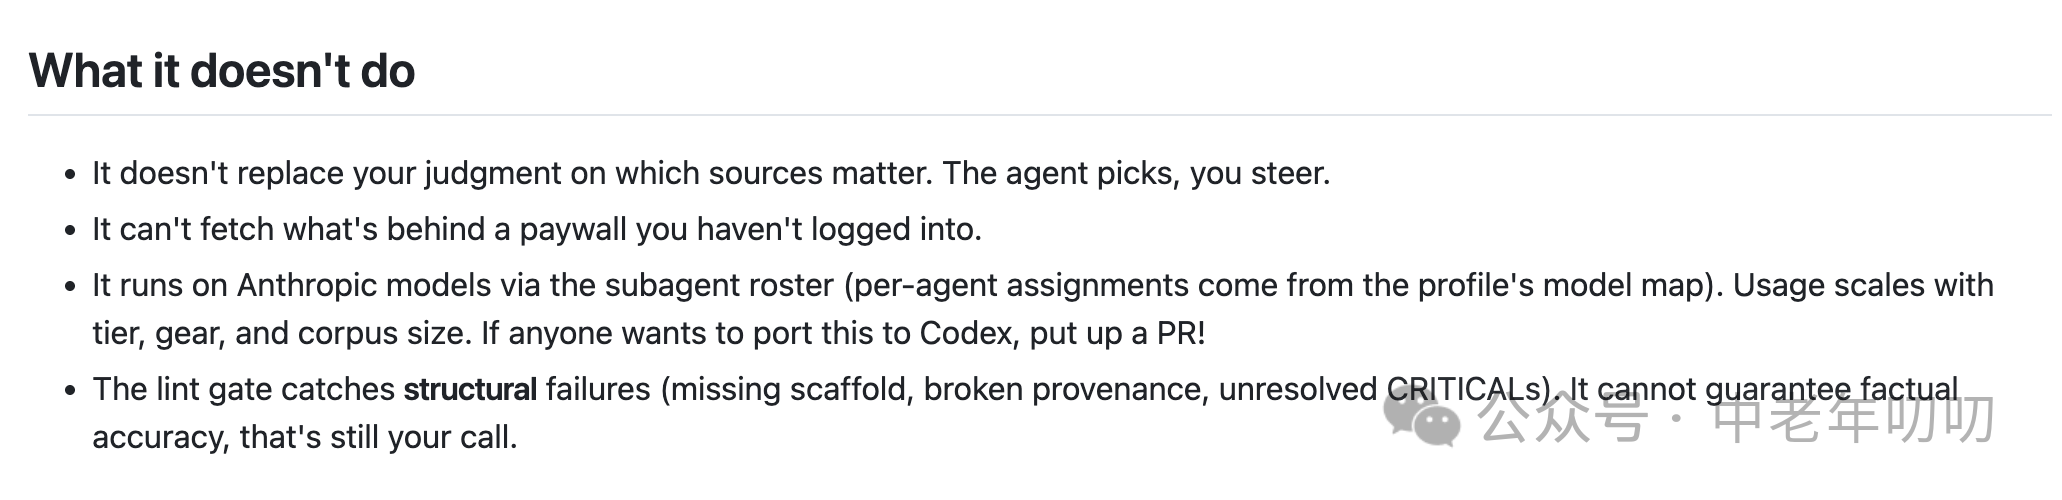
我的理解是: AI红队的设计目标不是替你做决策,是替你在决策前消灭信息盲区,为决策提供更多依据。
这就是红队思维的终局。
一个好的红队,不管是人还是AI,不帮你做决策。它帮你消灭”信息盲区”——那些你没看到、没想到、没查到的角落。
Hyper Research不会告诉你”这个结论是对的”,它会告诉你”这四个角度有反证据、有三条引用的原文跟你看到的不一样、有两个来源其实是同一篇新闻稿的转载”。然后你自己判断。
工具可以帮你跑完16步流水线。但决定”这个研究值不值得做""这个结论能不能信""这个风险能不能承受”的,还是你。
07. 原文来源
原文发表于微信公众号“中老年叨叨”(2026年7月22日 07:50)。查看微信公众号原文。